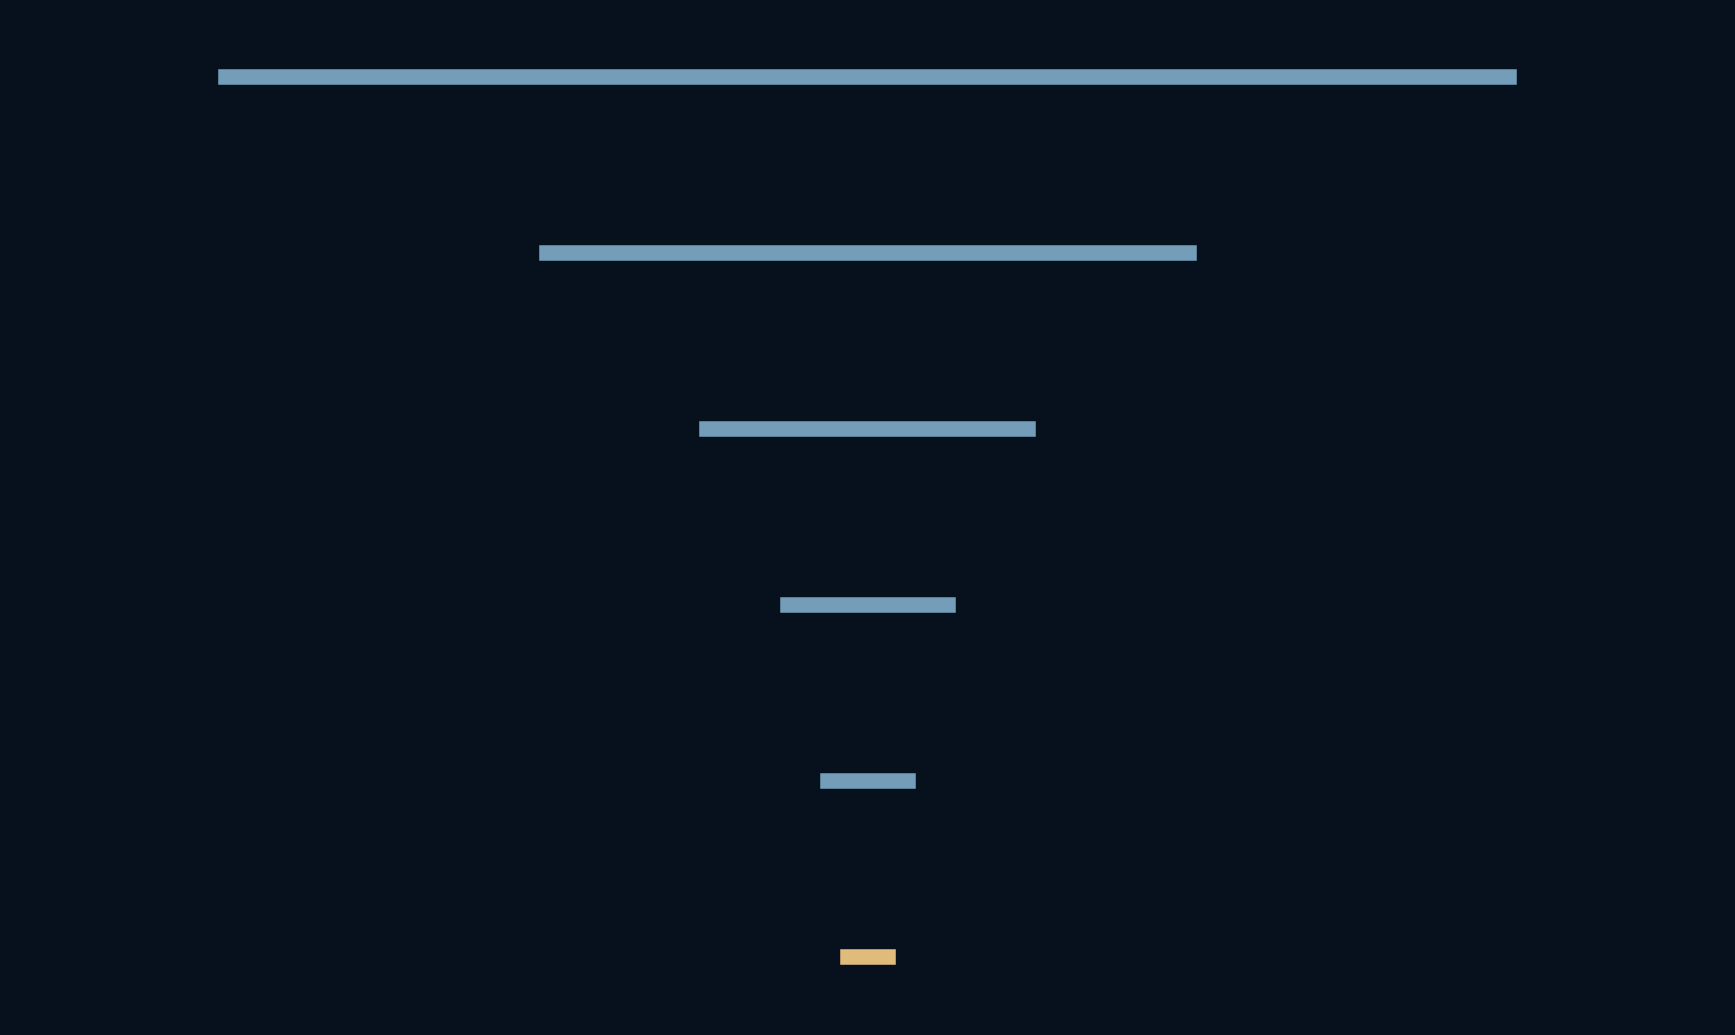
这段实现查找1,024个值,最多只需检查十一次中点。
样例按顺序放着0到2,046之间的所有偶数。逐项查找可以一个个看,二分查找却先看中间。如果目标更小,中点后面的所有值就都能排除。每次回答都让剩余不确定性大幅缩小。
有序,让一次比较带来许多项目的信息。
真正出力的是排序
程序维护包含两端的低、高索引,每次检查中间项。等于目标就返回位置;太小则只留右边,太大则只留左边,中点不再参与下一轮。
前提是列表按查找使用的同一种规则排序。否则,一个值比目标大,并不能说明那一侧其他值的情况。核心保证是:任何仍可能的匹配,都留在当前区间之内。
十一次“提问”具体指什么
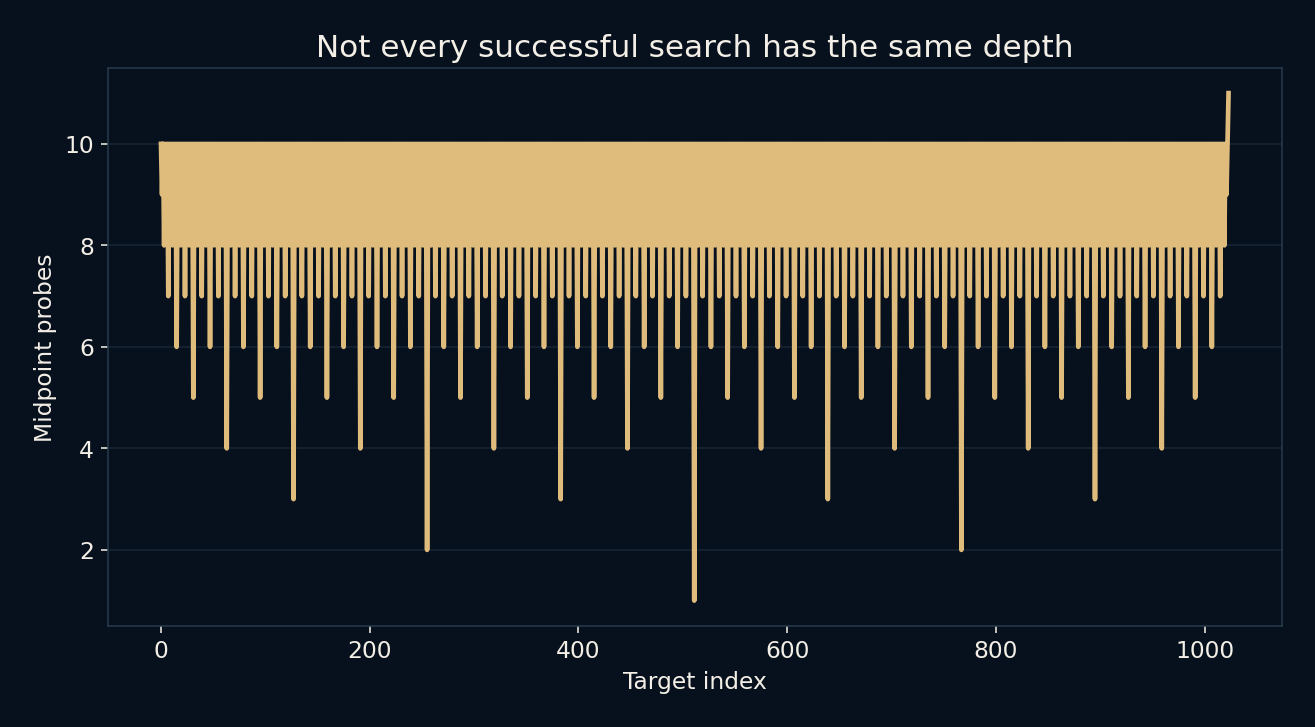
脚本分别查找全部1,024个已有键,核对每次返回索引。最多十一次中点检查,把所有目标等权平均则约9.012次。有的目标第一次就在中点找到,有的位于决策过程最深处。
这里一次探查指读取并检查一个中点,不等于Python比较指令、内存访问或耗时。一轮可能先测试相等,再测试大小。明确单位后,才能讨论查找深度,而不把结果悄悄变成性能基准。
翻倍大约只多一层
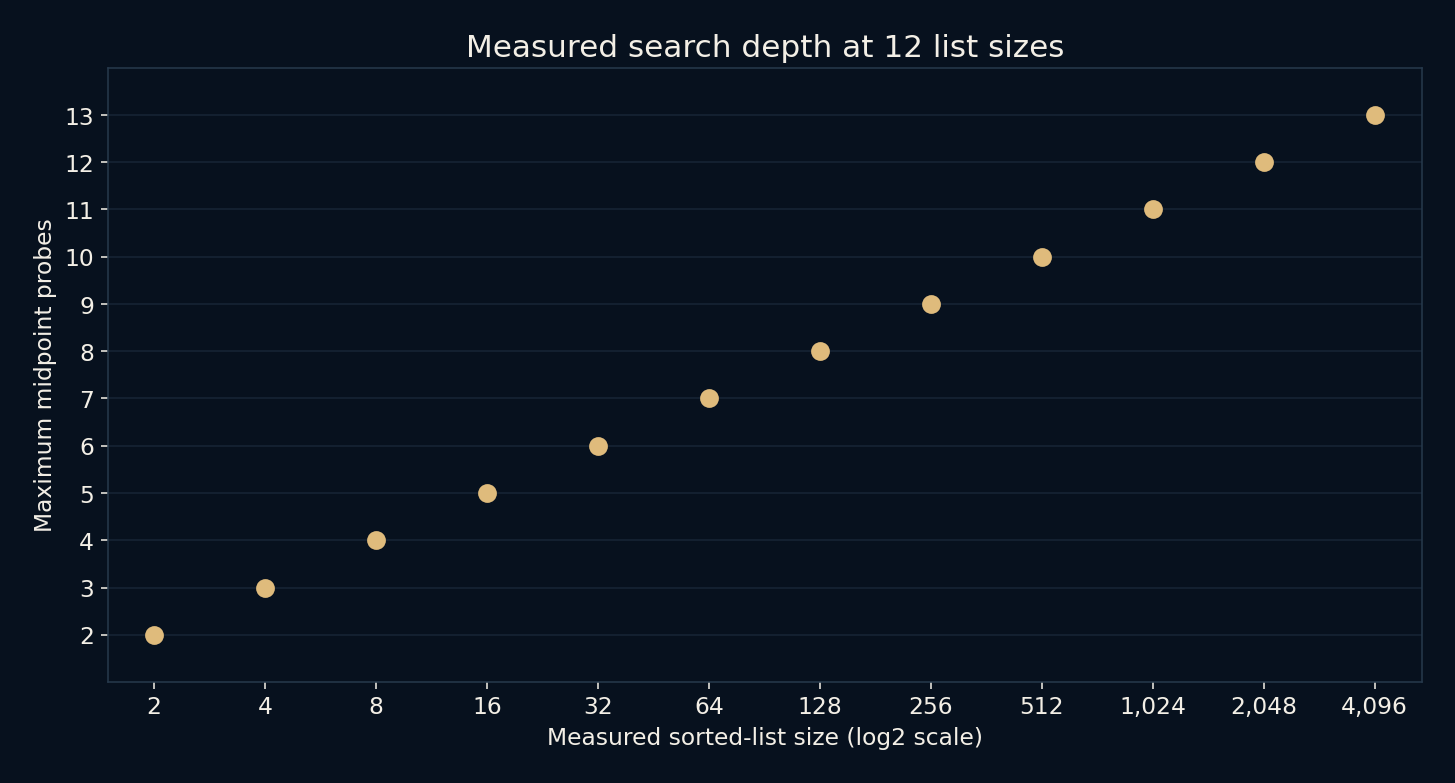
中点排除约一半候选后,下一个问题面对更小的列表。反复执行,探查次数呈对数增长。测试的二次幂规模中,最坏成功查找从两项时的两次,增长到4,096项时的十三次,每次规模翻倍,最大次数加一。
边界约定影响精确次数。这种包含两端的实现,在部分路径中会多一次最终检查,所以“1,024项恰好十次比较”是不准确的标题。增长思想依然成立,图里具体数字则应来自真实程序。
怎样证明已经没有候选
完整查找还要处理不存在的值。样例询问−1、1和2,048,前两个十次,最后一个十一次。低索引超过高索引时,区间已空,程序返回约定的“未找到”结果。
空输入不需任何中点检查。边界例子很重要:若区间没有正确缩小,漂亮算法也可能死循环或越界。重复键又需另定规则:找任意匹配、第一次、最后一次,还是插入边界。本例键各不相同,不包办所有重复策略。
快速查找的前提也有成本
把无序集合排好需要工作,因此一次性问题不一定值得先二分准备。反复查找可让维护顺序变得有价值,但在普通数组中插入仍可能移动许多项。Python的bisect文档也区分快速边界查找与更昂贵的插入。
直接访问中点同样重要。链式结构若要沿节点走到指定位置,照搬二分逻辑也不会拥有同样总成本。启发在于组织信息:有可靠的排除规则,加上便宜的访问,一个项目的答案就能排除许多其他项目。