计算最近的点很容易。难的是,选择在哪个空间里计算。
想象一个很小的目录,每件物品只有两个测量值。查询点表示你想找什么,最简单的推荐就返回离它最近的物品。不需要聊天、性格测试,也不需要大模型。不过,这个朴素系统已经包含一项重要设计决策:数字本身并不会告诉你,两种测量各自应该有多重要。即使物品完全没变,推荐结果也可能改变。
距离公式可以很精确,距离的含义却仍然需要商量。
先把物品放到可以测量的位置
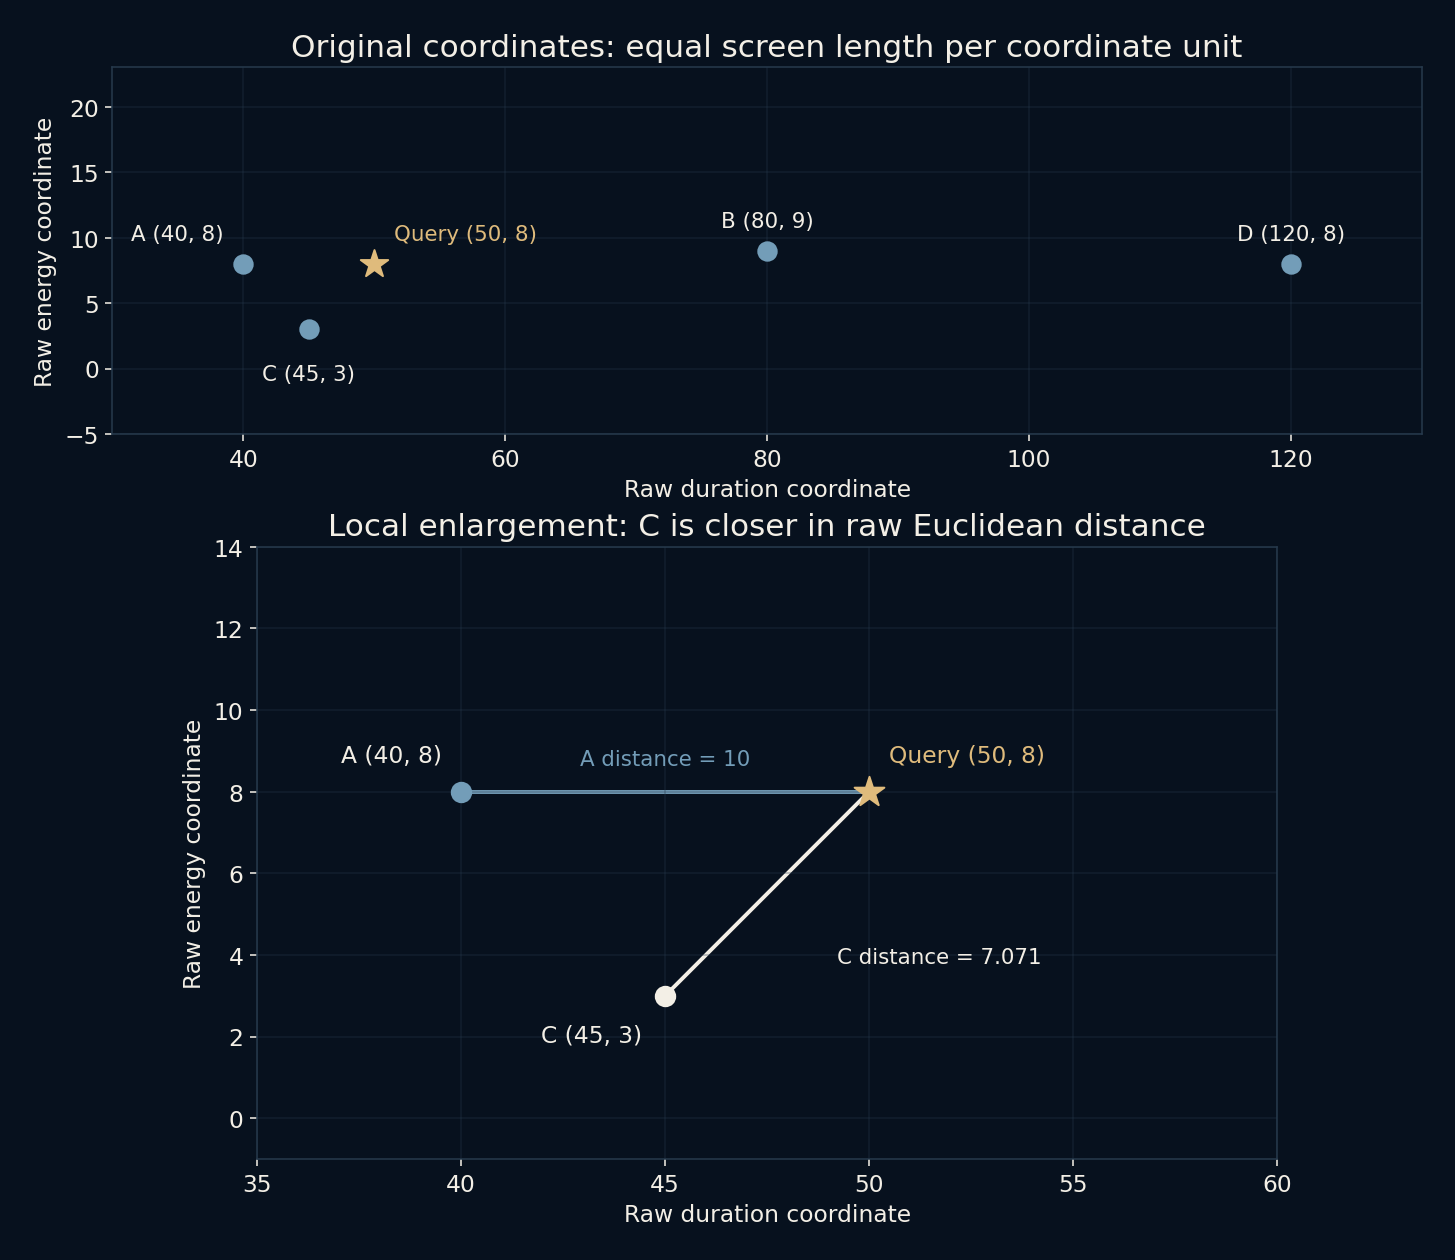
本例的查询点是 (50, 8)。A 到 D 四件物品分别位于 (40, 8)、(80, 9)、(45, 3)、(120, 8)。把坐标理解为两个虚构属性即可。这里没有把它们称作某个人的喜好,也没有假装它们是真实商品价格。实验只需要数值范围不同的两个特征,不需要编造一段从未观察过的顾客故事。
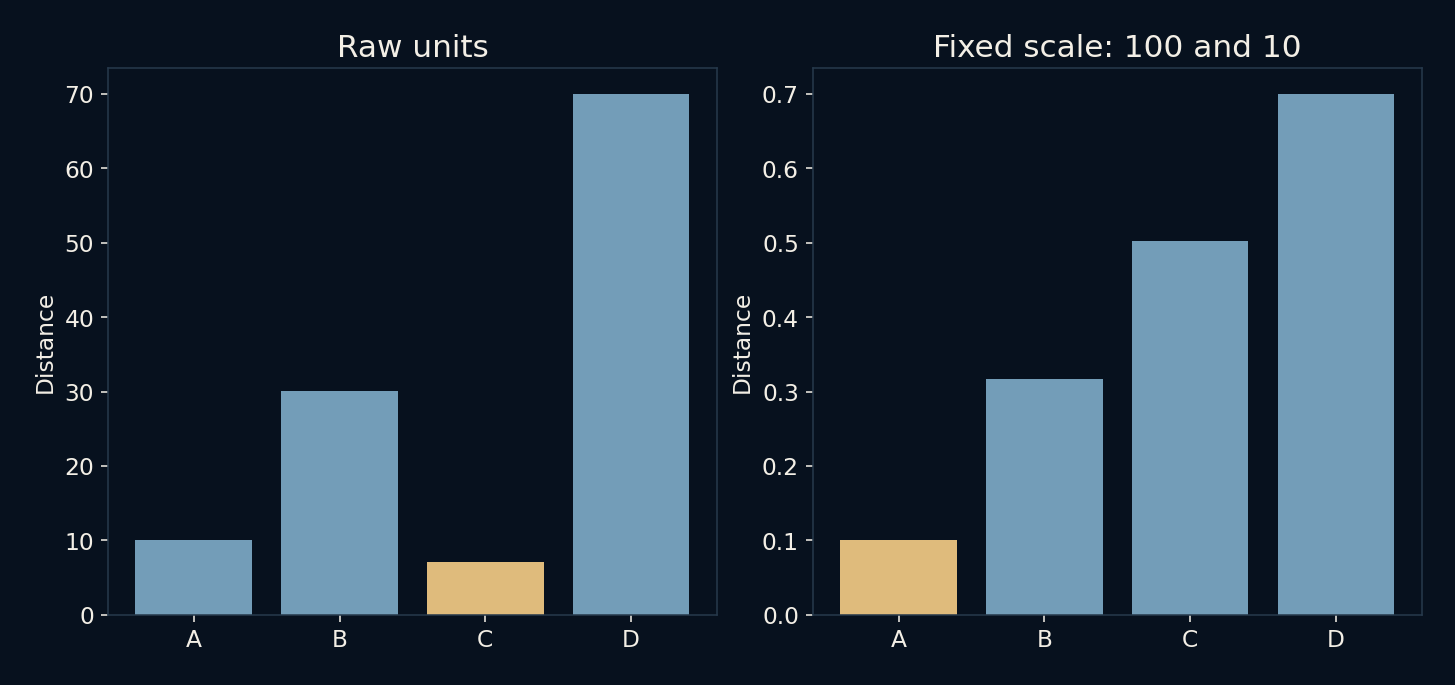
普通欧氏距离的算法是:各坐标相减,差值平方后相加,再开平方。C 的距离约为 7.07,胜过距离为 10 的 A。A 的第二个坐标明明完全匹配,但第一个坐标相差十,仍然大于 C 在两个坐标上各相差五所形成的距离。
单位,会悄悄变成优先级
这个答案在数学上没有错误。问题是,两条坐标轴的原始单位是否应该受到同等对待。如果一个特征通常在几百范围内变化,另一个只在十以内变化,相同的数字差值代表的变化程度可能非常不同。同一个长度,按毫米表示时数值是按米表示时的一千倍。物体没变,未经调整的距离却会变。
因此,特征缩放是模型的一部分,而非让数据看起来整齐的修饰。如果系统没有考虑单位就把它们混在一起,它仍然作出了一种选择:让数字的表示方式决定优先级,而且通常不会向看结果的人解释这件事。
一个实用检查是换单位但不改变重要性:把所有物品和查询的第一个坐标乘1,000,同时把对应尺度除数也乘1,000。扩展脚本发现距离在浮点容差内完全不变。若只换坐标、不换除数,改变的就不是记法,而是模型。这个检查能区分无害的单位表示变化与真正提高某特征重要性的决定。
换一个尺度,邻居就换了
现在先把第一个坐标的差值除以 100,第二个除以 10,再计算距离。A 的距离变成 0.10,C 约为 0.5025,因此最近的物品换成 A。B 和 D 则分别约为 0.3162 和 0.70。目录和查询都没有改变,改变的是距离被赋予的意义。
这两个除数是明确写出来的示例选择,不是从用户身上学来的估计,也不能证明新答案更好。实际应用的尺度可能来自有意义的物理单位、训练数据的波动程度,或经过验证的偏好模型。每种做法都有假设。如果数据分布变化了,先前拟合出的尺度也可能需要重新检查。
邻居可以提供线索,而不只是冠军
返回几个附近的物品,有时比宣布唯一匹配更有信息量。它们的距离可以显示第一名是否明显领先、几乎打平,或其实离所有候选都很远。只要系统总选最小值,再糟糕的目录也能产生第一名。因此,最近这个标签并不能单独说明结果已经近到有用。
实际系统还需要规定如何处理缺失值和并列。把缺失特征当作零,就是凭空编出一个测量值;把这个特征删掉,则改变了比较所用的空间。这些行为都不该悄悄发生。本例数据完整,第一名也没有并列,让几何效果更清楚,但没有解决这些生产环境中的问题。
把查询移到(500, 8),仍使用除数[100, 10],“足够接近”就具体了。远查询仍会产生第一名,这次是D,但距离为3.8,而原查询第一名只有0.1。示例接纳阈值0.2会接受原查询、拒绝远处查询。这个阈值没有学习得出,也不是对真实目录的建议。它只是说明选冠军与接受匹配是两个决定,系统可以回答没有合适结果。
整齐的坐标,可能漏掉最重要的事
两件物品可能在已记录的坐标上很近,却在系统从未测量的属性上差别巨大。只记录尺寸与重量的推荐,无法凭空知道某一种材质最重要。增加更多特征也不会自动解决问题。无用特征可能稀释有用特征,在高维空间里,人对邻近关系的直觉也会变得不那么可靠。
更合适的理解是:模型提出了一种关于哪些差异重要的主张。可以围绕明确任务检验它,但仅看漂亮散点图不够。好的推荐评估需要相关案例和真实结果。本篇既没有真实偏好,也没有留出的用户研究,因此不对满意度、准确率或转化作出承诺。
找出翻转点,而不只挑两个设置
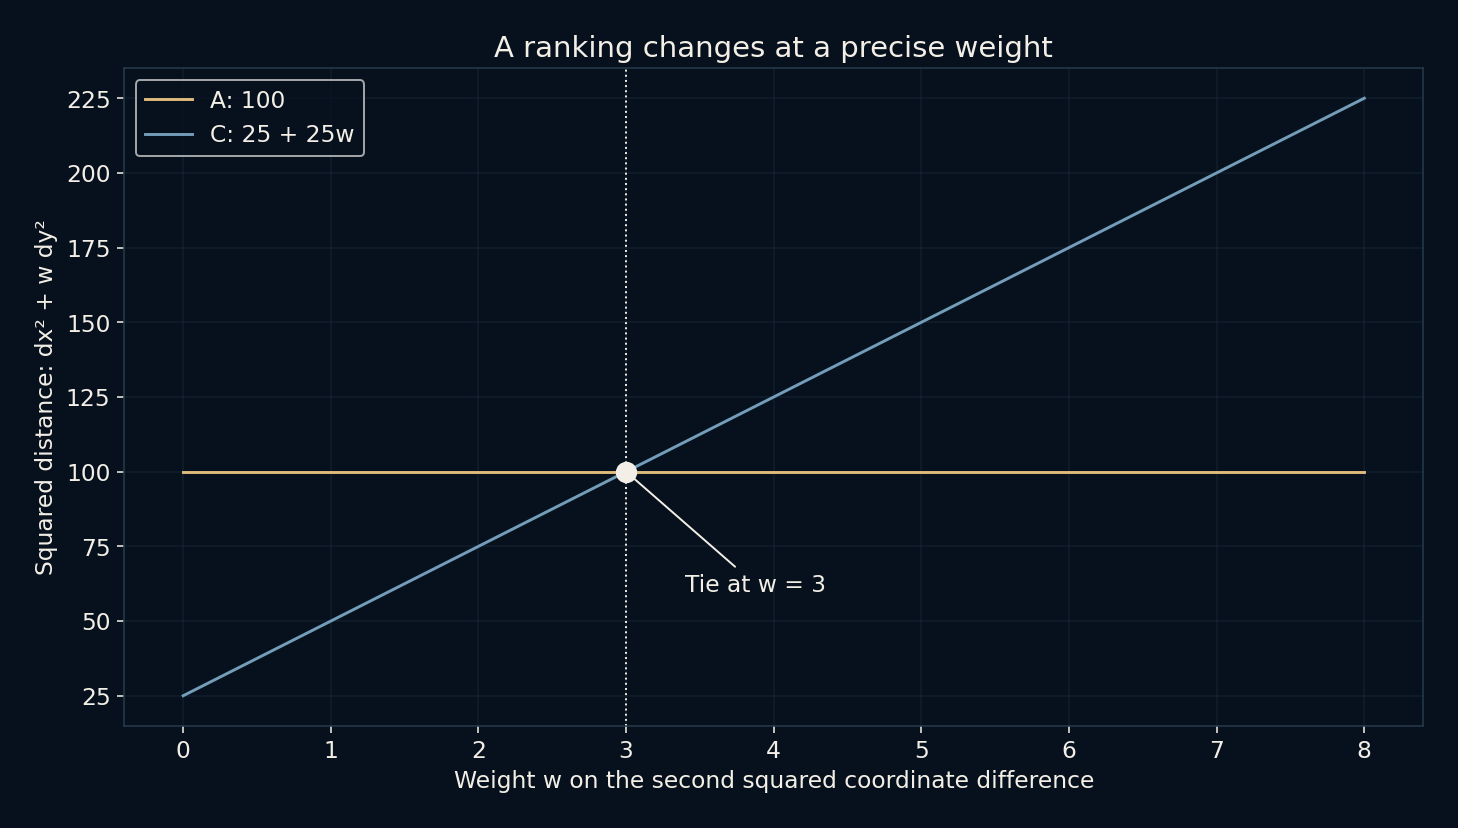
用一个可调数字,就能把选择摊开。第一个坐标差的平方不变,第二个乘权重w。A的距离平方为100,C为25 + 25w,因此w恰好为3时并列。权重2时,C为75,胜过A的100;权重4时,C为125,改由A获胜。在这个比较里B和D都不可能胜过A,所以这里确实是整个目录第一名的翻转边界。
原始欧氏距离相当于w = 1。前面的除数[100, 10],则在去掉所有距离平方共有的1/10,000因子后,相当于w = 100。共同因子改变数值大小,却不改变排序。新图聚焦三附近的翻转,而非把两个任意设置当作全部故事。若一个小而合理的权重变化就能改写推荐,展示多个候选可能比把冠军说成显而易见更有用。
先看清推荐,再谈它有多聪明
小而可见的例子,很适合提出那些不太讨喜的问题:记录了哪些特征?用了什么单位?如何缩放?只做一次无害的单位换算,答案会不会改变?系统能不能承认所有候选都不合适?这些问题没有讨论最新模型那么耀眼,却往往更能说明系统到底在做什么。
本地检查确认了两种尺度下的第一名,并验证查询点到自己的距离为零。比较范围刻意保持很窄,只展示缩放如何改变排序,没有决定真实服务应该用哪条缩放规则。最有用的结果并不是 A 获胜,而是我们能准确解释 C 为什么不再获胜。