관측 11개의 평균은 72.73이다. 그중 10개는 43보다 작다.
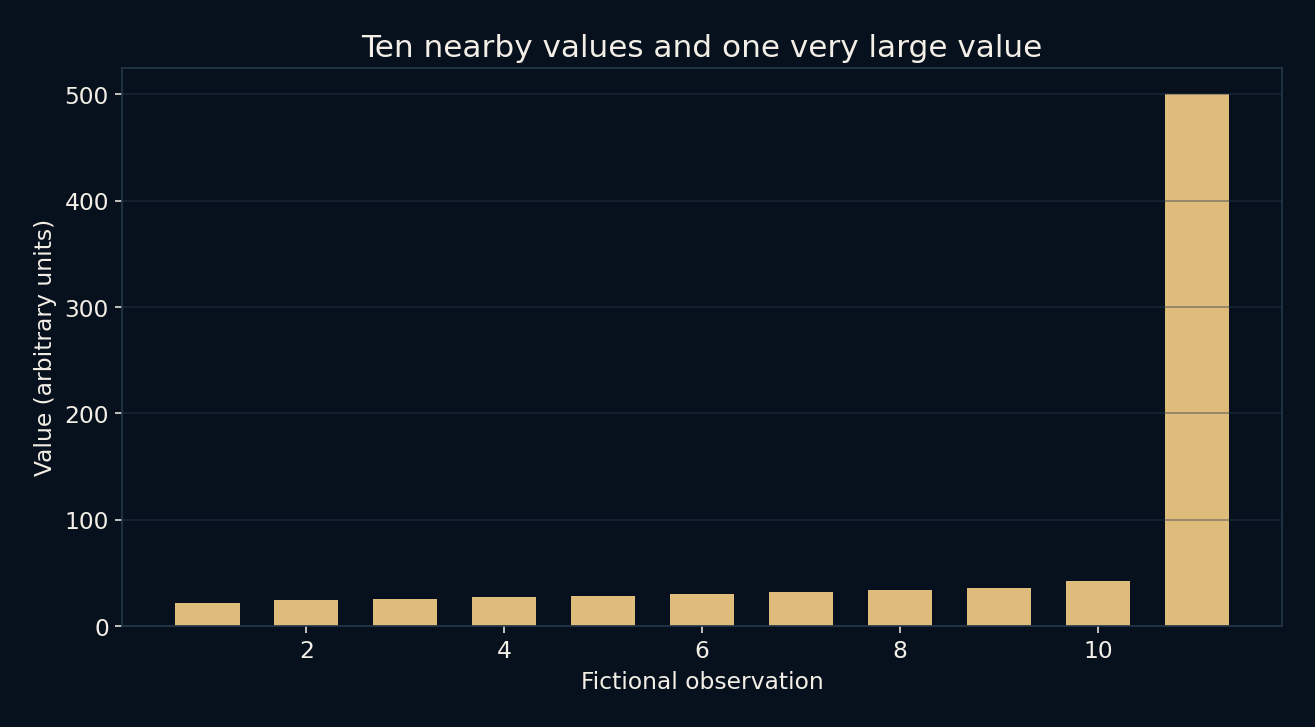
가상 목록은 22, 24, 25, 27, 28, 30, 32, 34, 36, 42로 시작하고 마지막에 500이 나온다. 임의 단위이며 급여, 집세나 사람을 측정한 값이 아니다. 의도적인 대비를 통해 같은 데이터를 세 가지 익숙한 요약으로 살펴보고 어떤 설명이 목록을 상상하게 돕는지 묻는다.
요약을 고른다는 것은 무엇을 보존할지 고르는 일이다.
움직이는 균형점
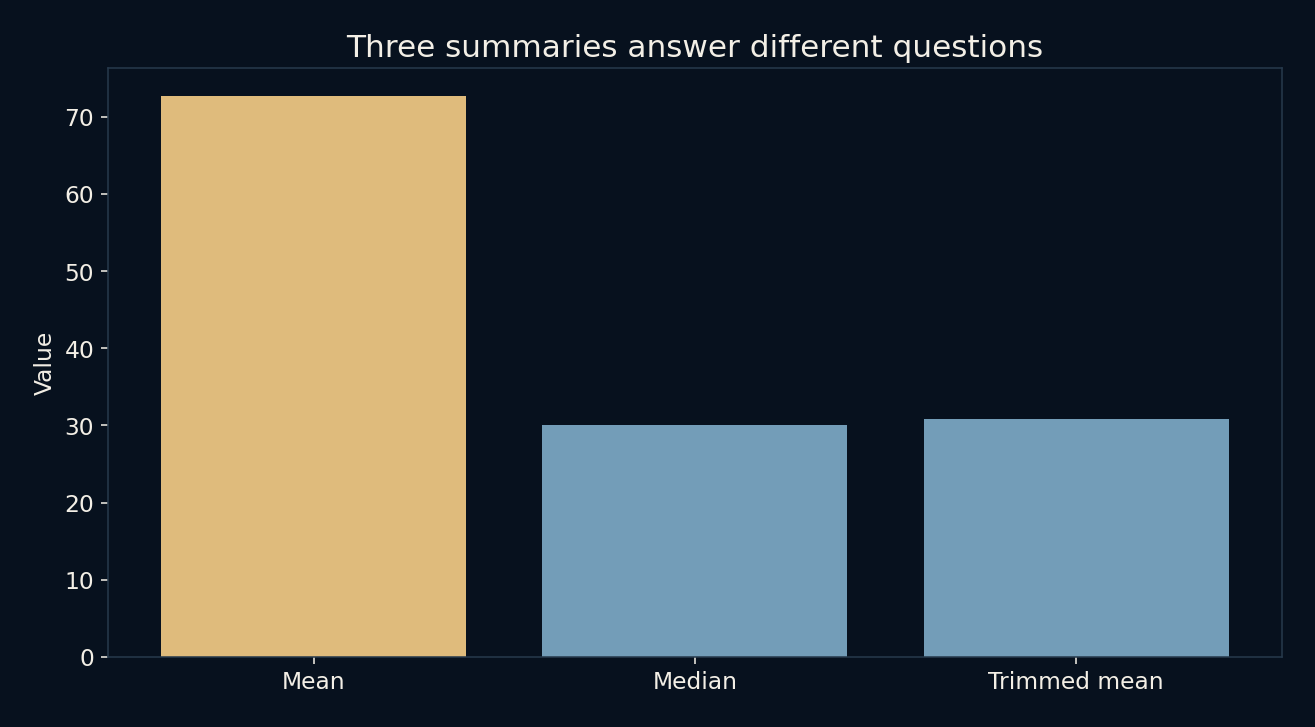
열한 값을 더하면 800이다. 11로 나누면 산술평균 72.7273을 얻는다. 평균은 총량을 보존한다. 평균 크기의 몫 열한 개를 합하면 다시 800이 된다. 그래서 회계, 예상 총량, 전체적으로 양이 어떻게 분배되는지 묻는 문제에 유용하다.
하지만 72.73에 가까운 관측은 없다. 열 개는 22~42에 있고 마지막은 500이다. 마지막을 빼면 앞의 열 개 평균은 정확히 30이다. 이는 계산 실패가 아니다. 큰 값은 총량에 그만큼 기여하며 평균은 그 정보를 남기도록 설계되어 있다.
정렬한 뒤 가운데 찾기
중앙값은 정렬한 목록에서 한가운데 관측을 묻는다. 열한 개 중 여섯 번째는 30이고 앞뒤에 다섯 자리씩 있다. 중앙 부근의 순서만 유지된다면 500을 5,000으로 바꿔도 중앙값은 그대로다.
이런 저항성은 치우친 분포의 전형적인 위치를 설명할 때 유용하다. 동시에 일부 정보를 의도적으로 버린다. 중앙값만으로는 위쪽 꼬리가 50에서 끝나는지 5,000까지 가는지 구별할 수 없다. 전체 부담이나 자원을 따진다면 그 차이가 가장 중요할 수 있다.
절사평균은 규칙을 공개해야 한다
실험은 가장 작은 값과 큰 값을 정확히 하나씩 빼고 남은 아홉 개도 평균했다. 합계 278을 9로 나누면 30.8889다. 예제를 위해 미리 정한 대칭 규칙이지 22와 500이 오류라는 통계적 판정은 아니다.
절사는 극단값의 영향을 줄이면서 중앙값보다 중앙부의 정보를 더 많이 남길 수 있다. 그러나 얼마나 뺄지는 모형의 선택이다. 불편한 결과를 본 뒤 값을 지우면 질문을 몰래 바꾸는 셈이다. 유용한 보고서는 규칙을 밝히고 원래 요약도 함께 남긴다.
전형적인 값과 총량은 다른 요청
목록의 보통 위치를 대표하려면 중앙값이 밀집한 가운데를 더 잘 떠올리게 한다. 총량을 똑같이 나누려면 평균이 올바른 몫이다. 어느 통계량이 언제나 우월하다고 선언해도 두 작업에 도움이 되지 않는다. 용도가 정보 압축에서 무엇을 남길지 결정한다.
분포 그림은 둘 모두의 간단한 동반자가 된다. 한 숫자가 숨기는 빈 구간, 군집, 고립된 값을 보여 준다. 실제 데이터라면 표본 크기와 흩어짐도 함께 적는 것이 좋다. 중앙값이 같은 두 집단의 꼬리가 다를 수 있고 평균이 같아도 전형적인 경험은 크게 다를 수 있다.
특이하다고 틀린 것은 아니다
멀리 떨어진 값은 자동 삭제보다 조사가 필요하다. 오타, 다른 단위, 다른 모집단, 실제 희귀 관측일 수 있다. 설명마다 조치가 다르다. 단위 오류는 바로잡아야 하지만 유효한 큰 관측은 요약을 불편하게 만들어도 남겨야 할 수 있다.
이 목록의 500은 일부러 넣었으므로 현실에서 어느 이유가 맞는지 알려 주지 않는다. 산술과 판단을 구별하는 것이 목적이다. 평균적인 사람이나 사례가 어떻다고 말하기 전에 그 수가 중앙을 설명하는지, 총량을 보존하는지, 두 역할을 동시에 맡으려는지 확인하자.