세 항목씩 담는 두 캐시에서 하나는 네 번, 다른 하나는 두 번 적중했다.
전체 작업은 ABCABDABCDAB 한 줄이다. 글자는 가상 객체를 요청하며 두 캐시는 빈 상태에서 시작한다. 이미 있으면 적중, 새로 가져와야 하면 실패다. 교체 규칙만 다르다. 작은 추적은 실제 컴퓨터 속도를 측정하는 척하지 않고 모든 결정을 살피게 한다.
캐시는 제한된 공간으로 하는 예측이다.
전부 기억하면 다툴 이유가 없다
가능한 객체는 네 개인데 칸은 세 개다. 첫 A, B, C는 빈 캐시에 없으므로 실패하고 이후 세 칸이 찬다. D가 오면 하나가 나가야 한다. 기억할지 말지가 아니라 과거의 어느 부분을 남길지가 질문이다.
모형은 객체 크기를 같게 보고 모든 실패를 같은 종류의 사건으로 센다. 다운로드 시간, 저장 가격, 조회 비용은 없다. 현실에는 크기와 결과의 차이가 있지만 이를 빼면 교체 규칙 자체를 비교하기 쉽다.
들어온 순서와 쓴 순서는 다르다
FIFO는 가장 먼저 들어온 객체를 내보낸다. 적중해도 도착 순서를 갱신하지 않는다. LRU는 마지막 요청이 가장 오래전인 객체를 내보낸다. 새 객체를 읽지 않는 적중에서도 최근 사용 순서는 바뀐다.
ABC 뒤에 A와 B가 오면 둘 다 적중한다. FIFO는 여전히 A를 가장 오래된 도착으로 보지만 LRU는 C를 가장 오래 안 쓴 것으로 본다. 다음 D에서 FIFO는 A를, LRU는 C를 제거한다. 이 차이가 다시 A와 B를 요청할 때 결과를 바꾼다.
이점에는 구체적인 원인이 있다
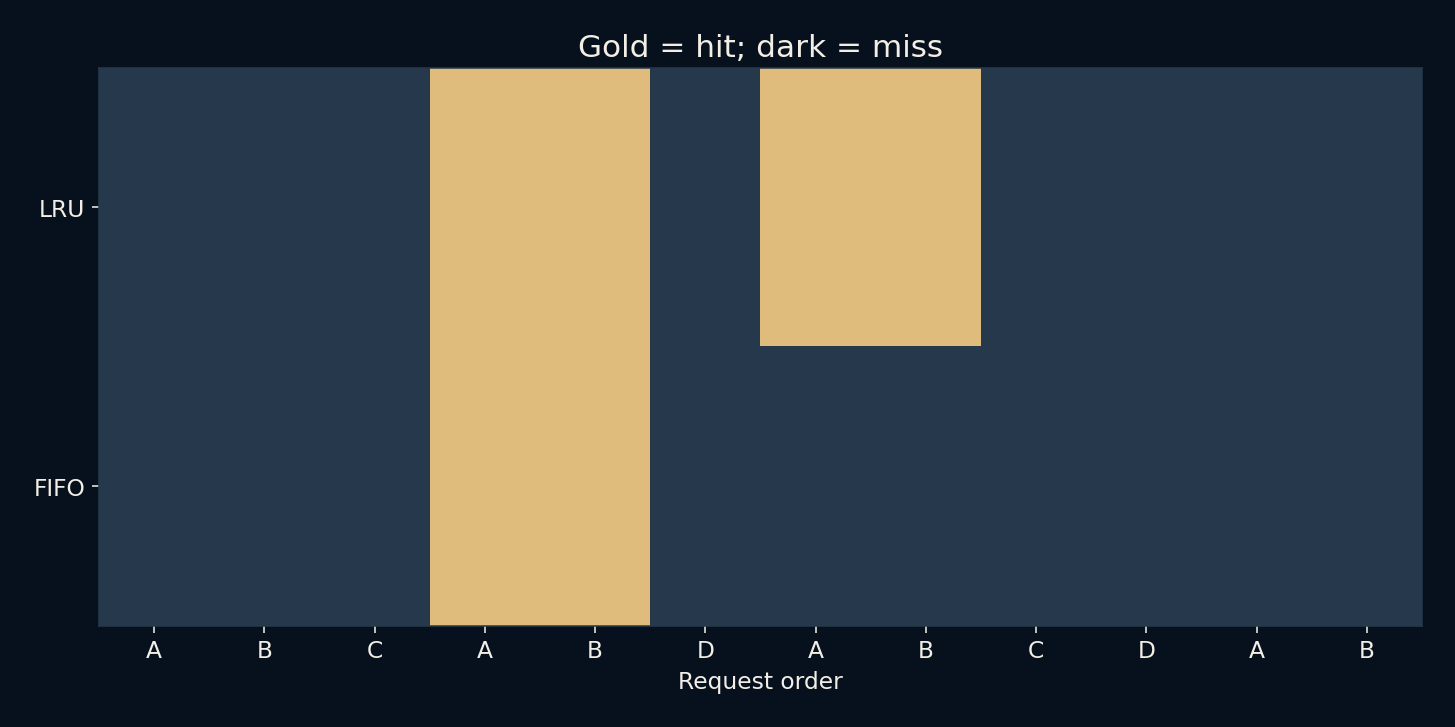
열두 요청에서 LRU는 네 번, FIFO는 두 번 적중해 각각 33.3%, 16.7%다. A와 B가 곧 다시 사용돼 LRU가 이득을 본다. 차이를 보이려고 고른 수열이지 사용자 탐색이나 프로세서 메모리의 무작위 표본은 아니다.
마지막 C D A B 네 요청은 세 칸 실행에서 둘 다 실패한다. 미래가 보호한 객체를 재사용할 때만 최근 사용이 도움이 된다. 공간보다 많은 객체를 계속 돌면 기대가 깨질 수 있다. 이 예에는 짧은 유용한 재사용과 이어지는 무적중 구간이 함께 있다.
네 번째 칸이 이야기를 바꾼다
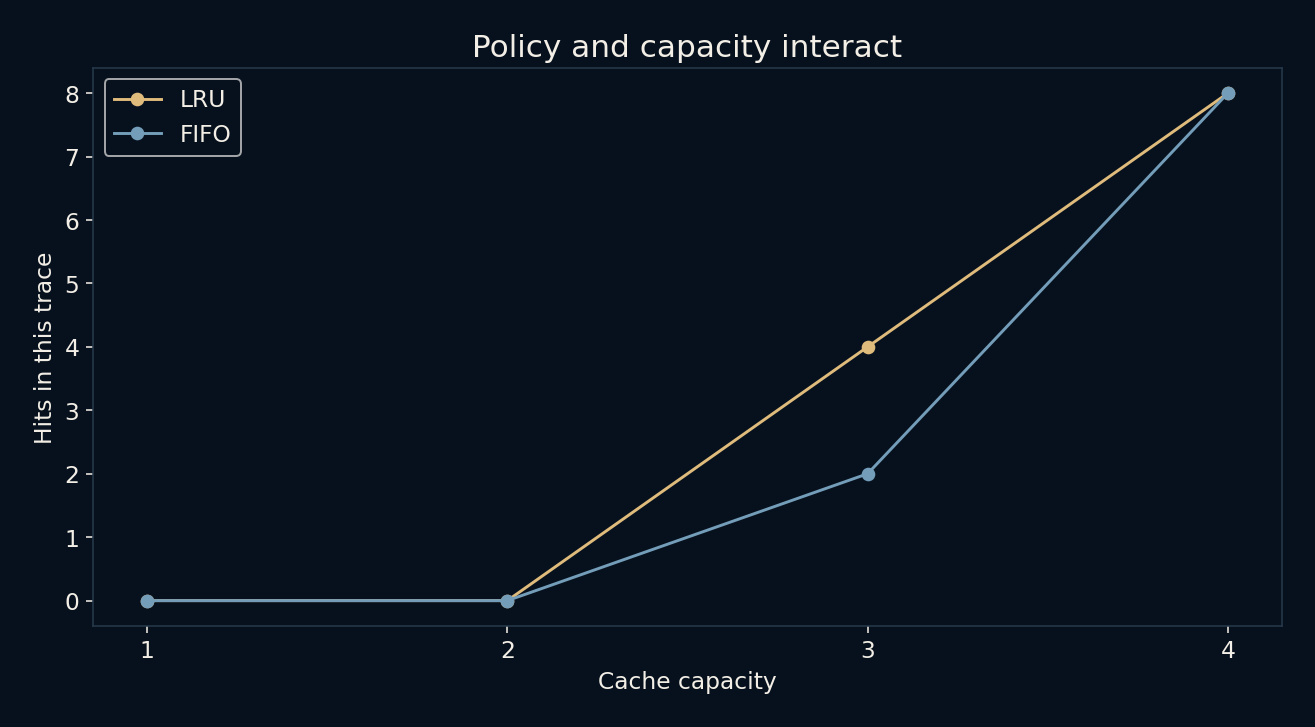
같은 추적을 한 칸부터 네 칸까지 반복했다. 네 칸이면 모든 객체를 한 번 읽은 뒤 남길 수 있어 최초 네 실패 다음에 둘 다 여덟 적중을 얻는다. 내보낼 필요가 사라져 정책 차이도 없어진다. 용량과 교체 방식은 독립 보장이 아니라 상호작용이다.
이는 불변 키 네 개와 고정 공간 예산에 한정된다. 실제 큰 캐시는 다른 작업과 메모리를 다투거나 큰 객체 하나가 작은 객체 여럿을 밀 수 있다. 용량 그림에는 가로축의 의미를 만드는 작업과 객체 크기 가정도 붙어야 한다.
기억한 것이 최신이라는 뜻은 아니다
캐시는 저장 결과가 언제 낡는지도 알아야 한다. 원본이 바뀌었는데 모르면 완벽한 적중률로도 틀린 답을 줄 수 있다. 만료, 검증, 명시적 무효화는 정확성의 문제다. 교체는 주로 공간이 찼을 때 어느 사본을 남길지의 문제다.
여기서는 최신성 장치를 모형화하지 않는다. 글자는 변하지 않는 객체이며 제거는 가상 캐시에서만 일어난다. 남길 것, 유효 기간, 다시 가져올 비용이라는 세 질문을 구별하는 것이 교훈이다. 최근 사용 규칙은 첫 질문에만 불완전하게 답하며 셋을 모두 해결하지 못한다.
더 읽어 보기
Python: LRU memoization semantics ↗Python: ordered dictionaries and reordering ↗공식 문서와 함께 읽으면 좋은 자료입니다.