데이터의 관계는 실제로 존재합니다. 거기에 붙인 이야기는 아닐 수 있습니다.
오른쪽 위로 기울어진 산점도를 보면 하나가 오르면서 다른 하나를 올린다고 설명하기 쉽습니다. 하지만 그림에는 영향의 방향을 나타내는 화살표가 없습니다. 두 측정값이 다른 무언가에 반응할 수도 있습니다. 이 모호함을 보기 위해 생성 과정을 아는 세계를 만들고, 첫 그림에서 한 재료를 숨겨 보겠습니다. y를 만드는 과정에 x를 쓰지 않아도 강한 상관이 나타납니다.
패턴은 무엇이 함께 움직였는지 설명합니다. 인과 질문은 개입하면 무엇이 달라지는지 묻습니다.
숨은 재료 하나가 두 측정값에 들어갑니다
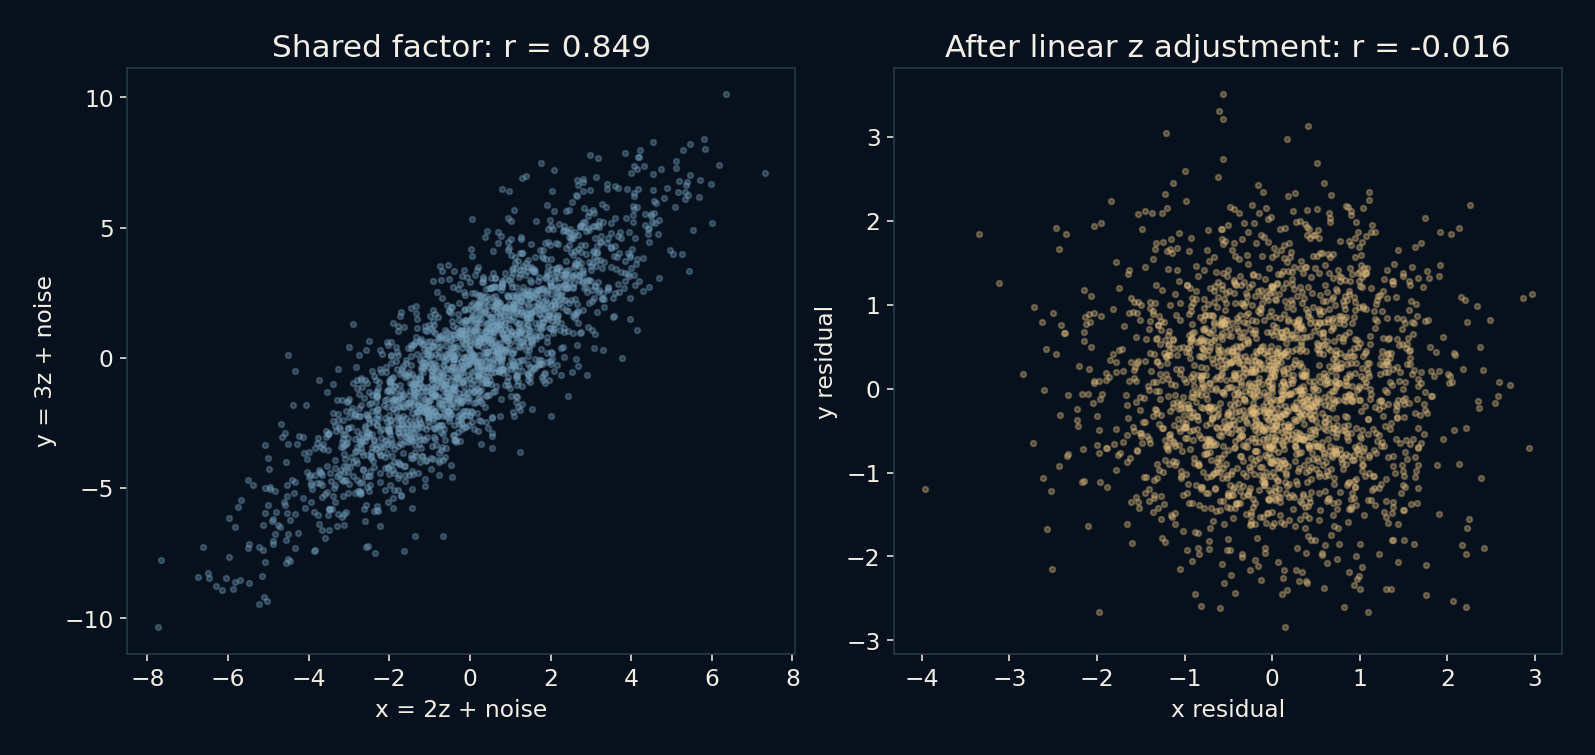
실험은 시드 941로 데이터 2,000행을 만듭니다. 각 행에는 표준정규분포에서 뽑은 z가 있습니다. x는 z의 두 배에 독립적인 표준정규 잡음을 더하고, y는 z의 세 배에 별도의 독립적인 잡음을 더해 만듭니다. 모든 행에 같은 규칙을 적용하므로 z가 크면 x와 y도 함께 커지는 경향이 있습니다.
이 구성에서는 어느 측정값도 다른 측정값을 만드는 입력이 아닙니다. 공통 재료가 연관을 만듭니다. 이를 아는 이유는 산점도가 인과 구조를 밝혀서가 아니라 생성식을 직접 썼기 때문입니다. 실제 관측에서 비슷하게 생긴 그림은 직접 영향, 반대 방향의 영향, 공통 원인, 선택 효과 등 여러 설명과 양립할 수 있습니다.
강한 계수는 설명이 아닙니다
피어슨 상관은 각 변수의 척도를 반영한 뒤 선형 연관을 요약합니다. 입력이 상수가 아니라면 값은 -1에서 1 사이입니다. 여기서 원래 표본 상관은 약 0.8494로, 생성한 행들에 강한 양의 선형 패턴이 있습니다. 인과관계일 확률이 84.94퍼센트라는 뜻도, x를 한 단위 바꾸면 y가 0.8494단위 바뀐다는 뜻도 아닙니다.
이 계수는 모든 관계를 감지하지도 못합니다. 곡선 형태의 패턴은 선형 상관이 작을 수 있고, 특이한 점 몇 개가 표본 계수에 큰 영향을 줄 수도 있습니다. 숫자와 산점도를 함께 보면 무엇을 측정했는지 설명하는 데 도움이 됩니다. 그러나 어느 쪽도 어떤 개입이 어떤 결과를 바꿀지에 관한 빠진 정보를 채워 주지는 않습니다.
생성식을 알면 표본 전에 모집단 계수도 계산할 수 있습니다. 독립성 때문에 Var(x) = 2² + 1 = 5, Var(y) = 3² + 1 = 10, Cov(x, y) = 2 × 3 = 6입니다. 모집단 상관은 6을 50의 제곱근으로 나눈 약 0.84853으로, 관측한 0.84938과 가깝지만 다릅니다. y를 x로 회귀한 모집단 기울기는 6/5, 즉 1.2입니다. 그래도 이 세계에서 x만 바꾸는 효과는 0입니다. 회귀 기울기와 개입 효과는 같은 수일 필요가 없습니다.
z로 적합한 선형 부분을 빼 봅니다
다음으로 z에 대한 x의 직선과 z에 대한 y의 직선을 각각 적합합니다. 두 회귀 모두 절편을 포함합니다. 관측값에서 각 적합값을 빼면 잔차가 남습니다. 적합한 z와의 선형 관계로 설명하지 못한 부분입니다. 두 잔차 배열의 상관은 약 -0.01591로, 이 표본에서는 정확히 0이 아니라 0에 가깝습니다.
큰 변화는 이미 알고 있는 생성 방식과 일치합니다. 공통 선형 성분을 제거한 뒤 주로 독립적인 잡음이 남은 것입니다. 의도적으로 유리한 조건에서 조정을 보여 준 예제입니다. 알 수 없는 데이터에서 올바른 통제 변수를 발견하는 절차가 아니며, 실제 연구에서는 잔차 상관이 작다는 사실만으로 인과 효과가 없다고 입증할 수 없습니다.
같은 값도 다른 행에서는 다른 이야기가 됩니다
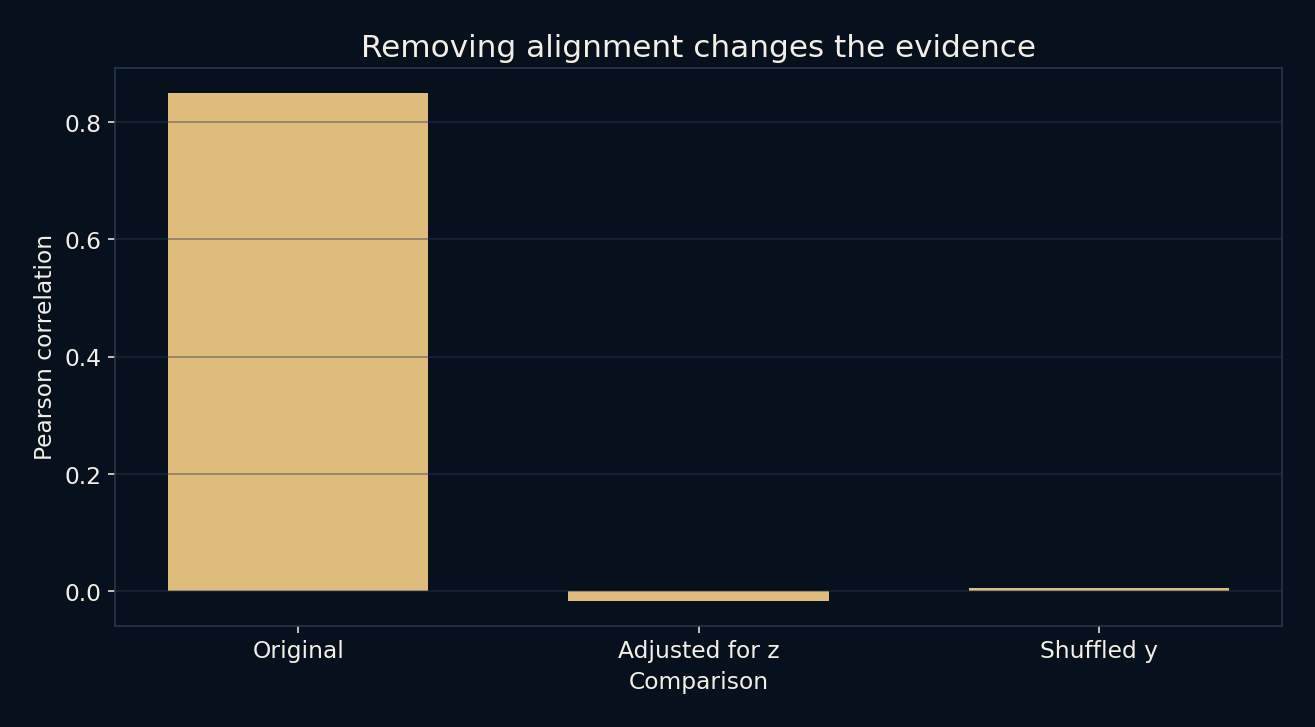
별도의 비교에서는 x를 그대로 두고 원래 y 값의 순서를 섞었습니다. 모든 y 값이 남으므로 그 열의 분포와 평균은 달라지지 않습니다. 사라지는 것은 원래의 행별 대응입니다. 상관은 약 0.005705가 됩니다. 연관은 두 열을 각각 볼 때의 모습뿐 아니라 어떤 값끼리 짝을 이루는지에 달려 있음을 보여 줍니다.
이는 고정 시드로 만든 순열 한 번이며, 완전한 순열 검정이나 유의성 계산이 아닙니다. 더 중요한 점은 섞기가 x를 무작위로 배정한 뒤 새로운 결과를 관찰하는 일과 다르다는 것입니다. 기록된 짝을 바꿀 뿐 측정값을 만든 과정은 바꾸지 않습니다. 표에서 연관을 없앤다고 현실의 원래 연관이 설명되지는 않습니다.
모든 변수를 통제하는 것이 인과 전략은 아닙니다
실제 데이터에는 믿을 만한 생성식이 붙어 있지 않습니다. 중요한 공통 원인을 측정하지 않았거나, 측정 오차가 있거나, 결과와 비선형적으로 연결될 수 있습니다. 어떤 변수를 조정할지는 인과 질문과 가정한 관계에 달려 있습니다. 열을 더 많이 모으는 것이 그 관계를 알아내는 것과 같지는 않습니다.
조정이 측정하려던 효과의 일부를 없앨 수도 있습니다. 영향 과정의 중간 결과를 통제하는 경우가 그렇습니다. 두 변수의 공통 결과를 조건으로 삼으면 연관을 없애기는커녕 새로 만들 수도 있습니다. 그래서 사용 가능한 변수를 모두 통제하라는 조언은 안전하지 않습니다. 회귀를 적합하기 전에 연구 설계, 분야 지식, 명시적인 가정을 살펴야 합니다.
두 세계는 같은 종류의 점구름을 만들 수 있습니다
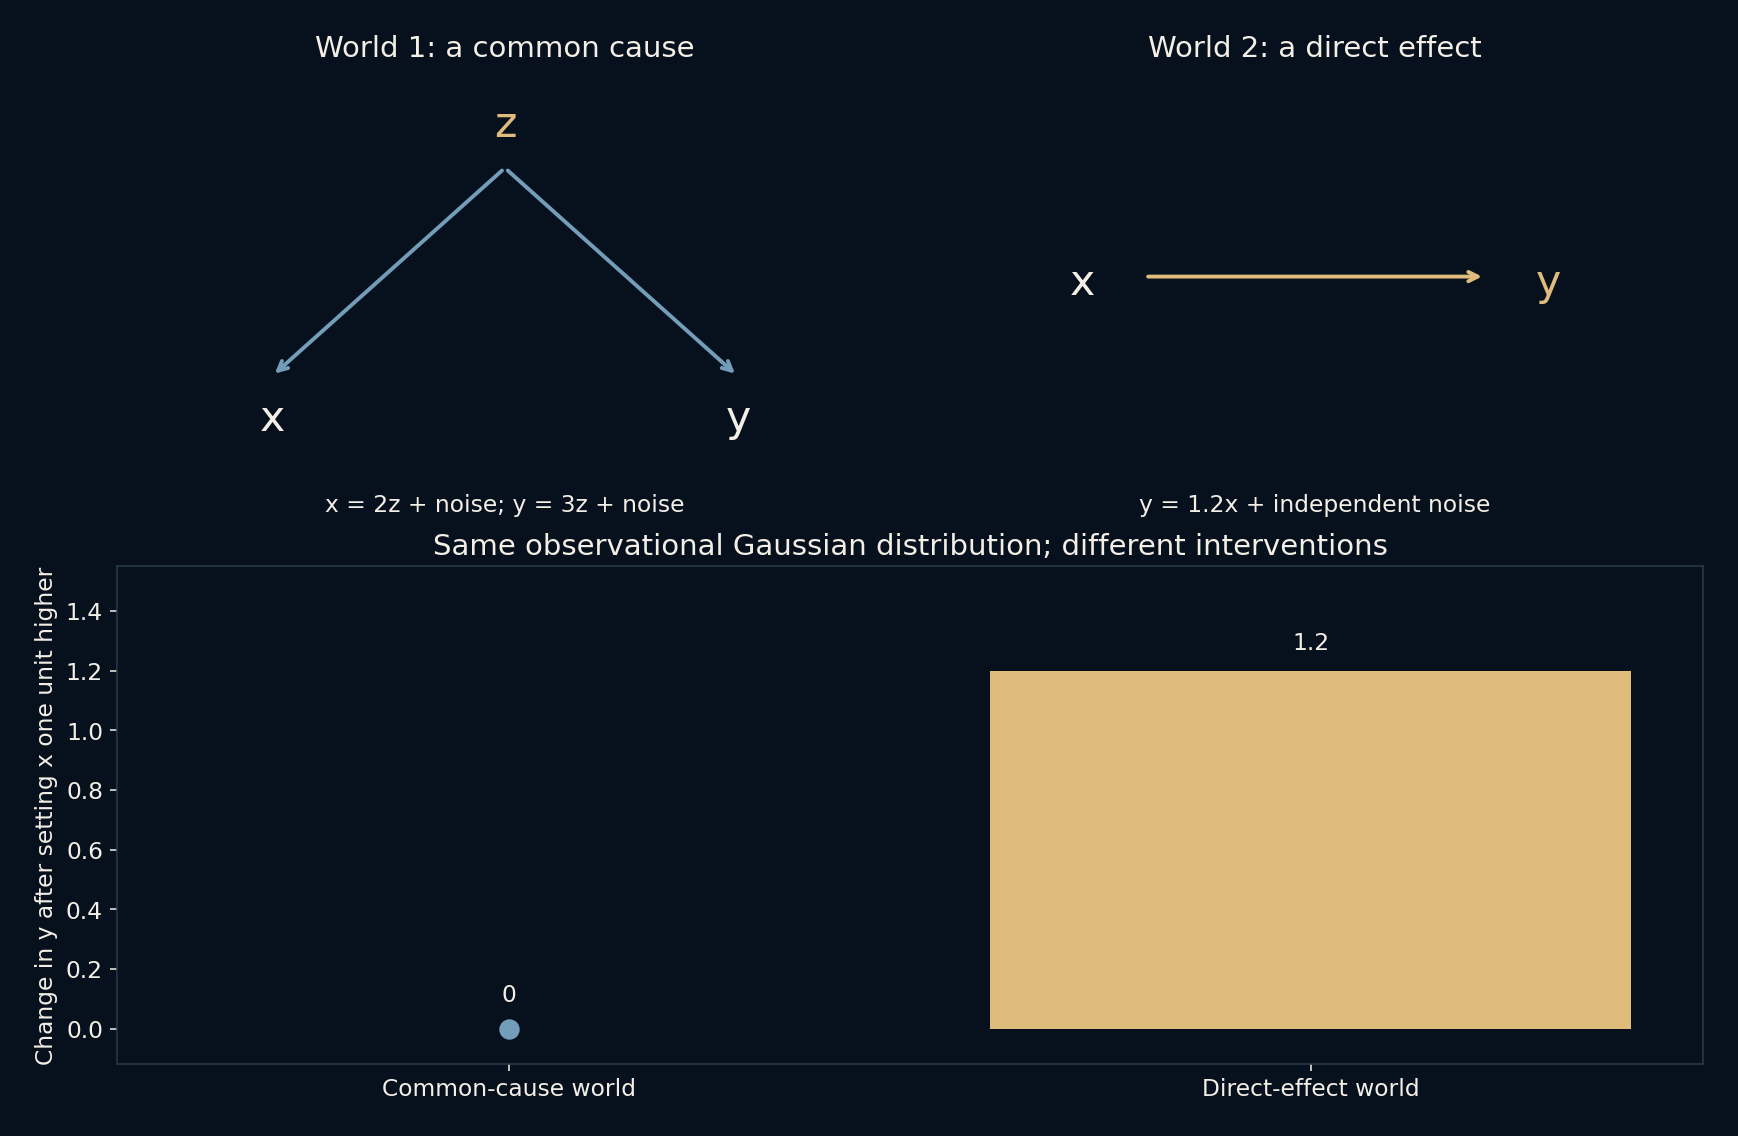
둘째 세계에서는 x가 평균 0, 분산 5인 정규변수이고 y는 1.2x에 분산 2.8의 독립 정규 잡음을 더한 값입니다. 여기서는 x가 실제로 y의 입력입니다. 그런데 관측하는 두 변수의 결합 가우스 분포는 공통 원인 세계와 정확히 같습니다. 평균은 모두 0, 분산은 5와 10, 공분산은 6입니다. 평균과 공분산이 결합 가우스 분포를 결정합니다. 분포가 같다는 뜻이지 무작위 표본 두 개가 점마다 일치한다는 주장이 아닙니다.
이제 다른 외부 재료를 고정하고 각 모형에서 x를 1만큼 올리는 개입을 합니다. 공통 원인 세계의 y 식은 x를 읽지 않으므로 모든 y가 그대로입니다. 직접 효과 세계에서는 모든 y가 1.2씩 오릅니다. 스크립트는 두 반응과 관측 공분산 행렬을 검사합니다. 같은 두 변수의 관측을 아무리 더 모아도 분포만으로 정한 두 세계를 구별할 수 없습니다. 개입 설명을 선택하려면 실험, 정당한 추가 지식, 다른 증거가 필요합니다. 이는 산점도에서 인과를 발견한 결과가 아니라 작성한 모형에서 나온 결론입니다.
관찰과 설명을 구분해 두세요
설득력 있는 연관을 보면 먼저 각 행이 무엇인지, 관측을 어떻게 선택했는지, 어떤 측정값을 짝지었는지 물어보세요. 그런 다음 실제 주장이 무엇인지 확인합니다. 함께 변하는 모습을 설명하는 일, 다른 값을 예측하는 일, 개입 효과를 추정하는 일은 다릅니다. 유용한 예측 패턴이 개입 질문에도 올바른 답을 주는 것은 아닙니다.
로컬 검사는 행의 대응, 잔차와 z의 직교성, 그리고 이 예제에서 예상한 강한 원래 상관과 작은 잔차 상관을 확인합니다. 구현 성질과 선택한 예제를 검사할 뿐 인과 효과를 식별하지는 않습니다. 교훈은 모든 상관을 의심하라는 것이 아닙니다. 상관이 제 역할을 하게 두고, 증거가 세우지 못한 설명까지 계수 하나에 맡기지 말자는 것입니다.