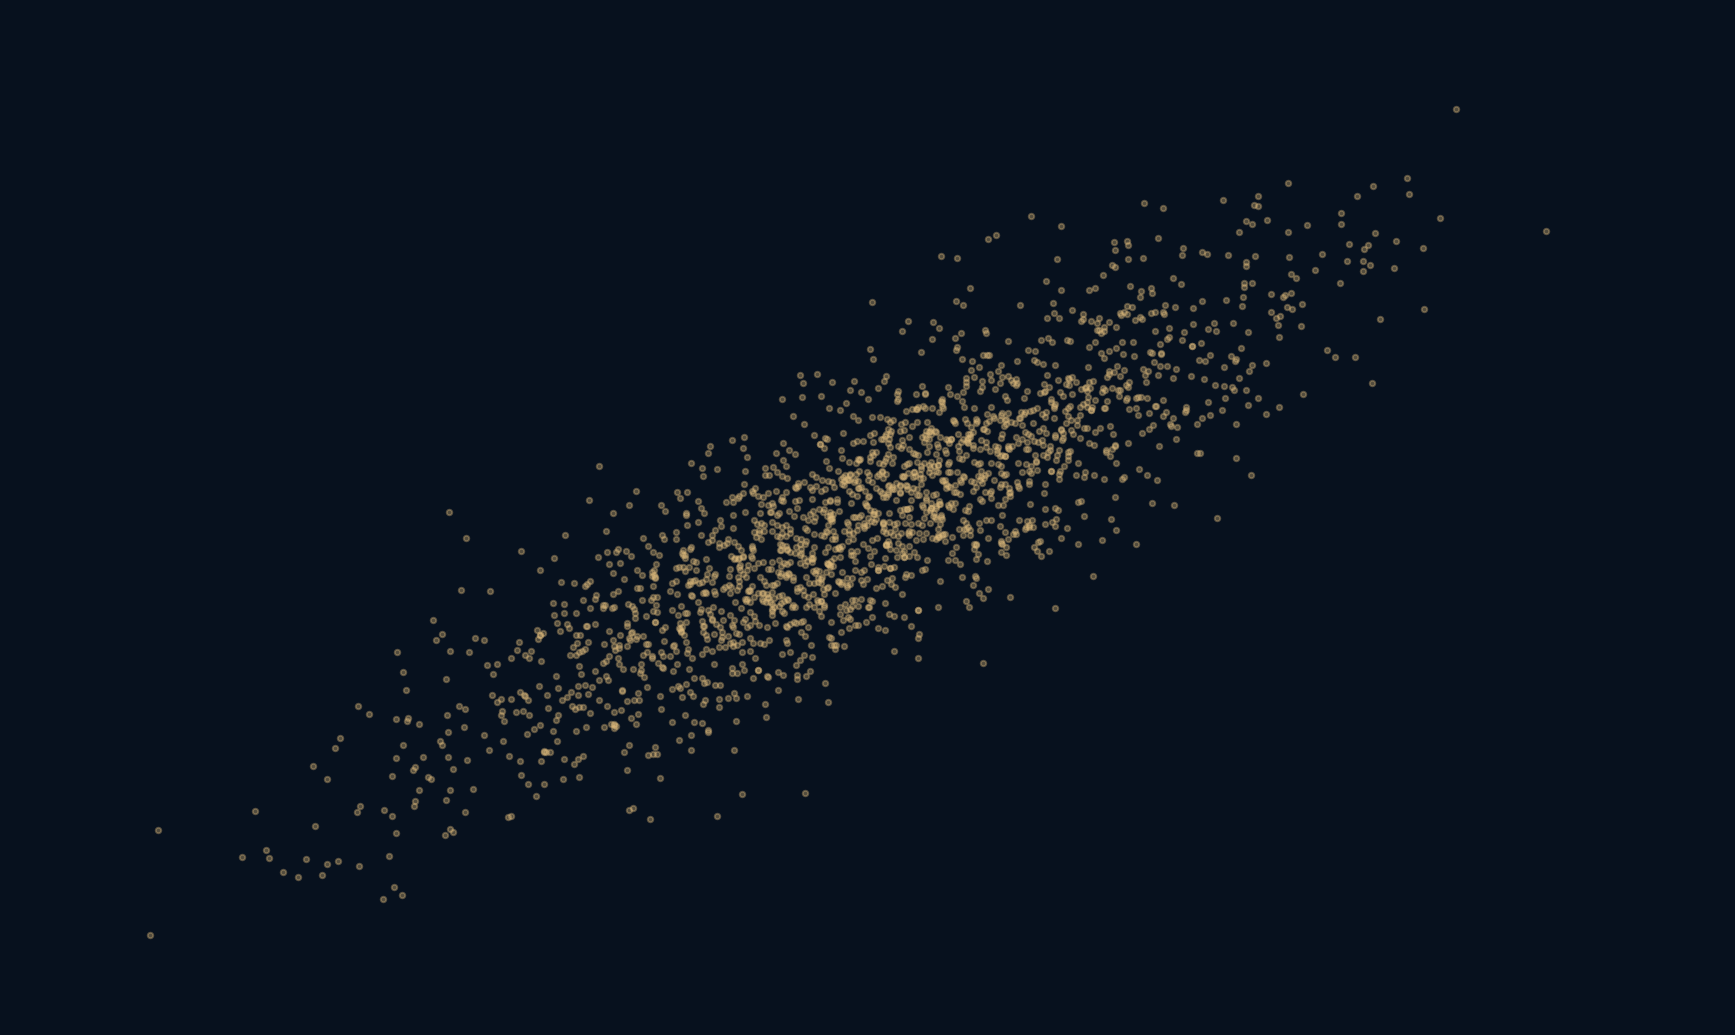
数据里的关系确实存在,但附在它上面的故事未必成立。
一张明显向右上方倾斜的散点图,很容易让人作出简单解释:一个量上升,带动另一个量上升。但图里并没有这支表示影响方向的箭头。两种测量可能都在响应别的因素。为了把这种歧义看清,我们可以建立一个生成机制已知的世界,再从第一张图里藏起其中一个成分。这样得到的相关性很强,尽管生成 y 的过程从未用到 x。
模式描述哪些量一起变化;因果问题问的是,主动干预后什么会改变。
同一个隐藏成分,进入两种测量
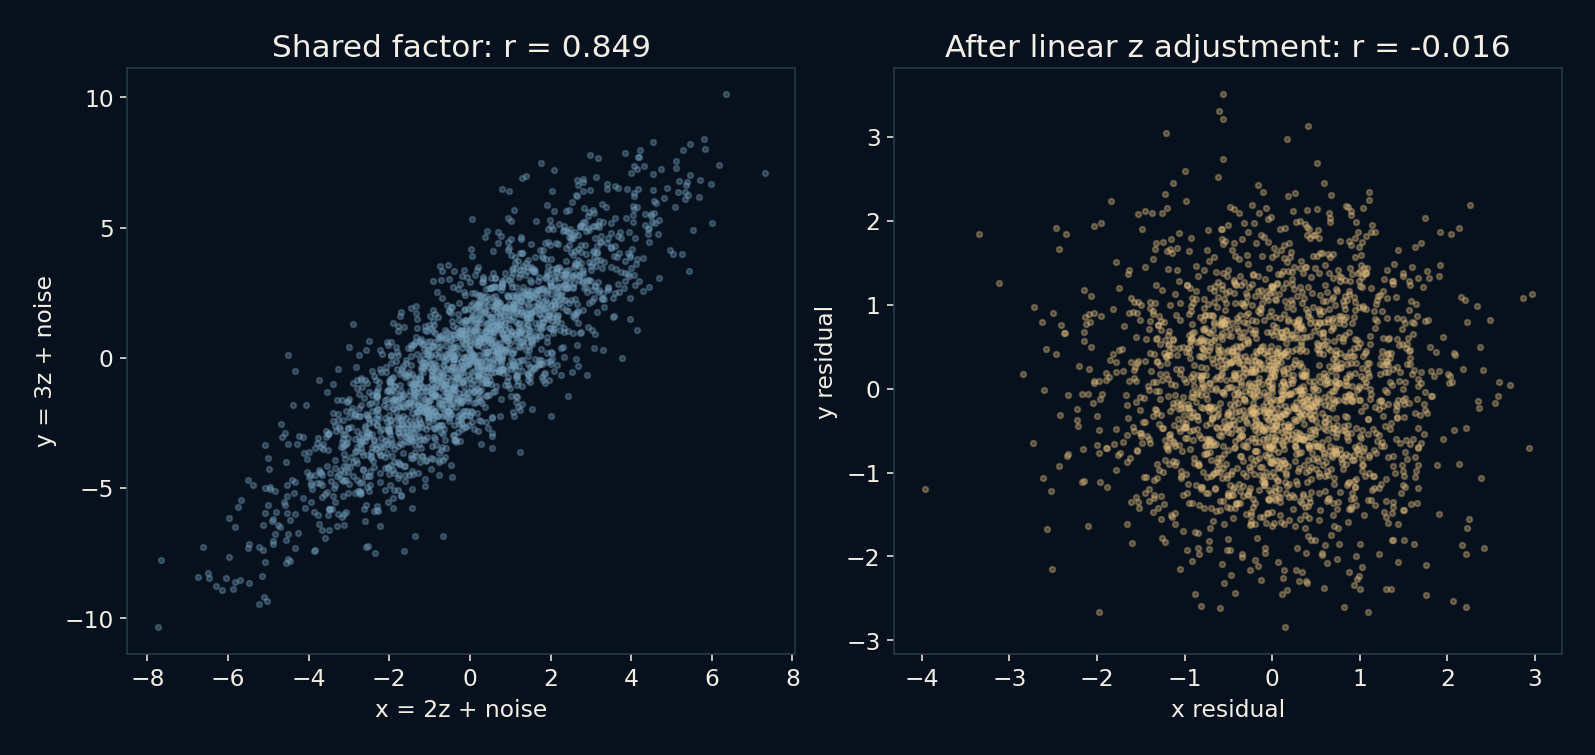
实验使用种子 941,生成 2,000 行数据。每行有一个服从标准正态分布的 z。x 等于 z 的两倍加上一份独立的标准正态噪声,y 等于 z 的三倍加上另一份独立噪声。各行遵循相同生成规则,因此较大的 z 往往同时产生较大的 x 和 y。
在这个特定构造里,两种测量没有互相输入对方的生成过程,关联来自共同成分。我们知道这一点,是因为亲手写下了生成方程,而不是散点图揭示了因果结构。真实观测中一张类似的图,可能对应直接影响、反向影响、共同原因或选择效应等不同解释。
一个很强的系数,不等于一个解释
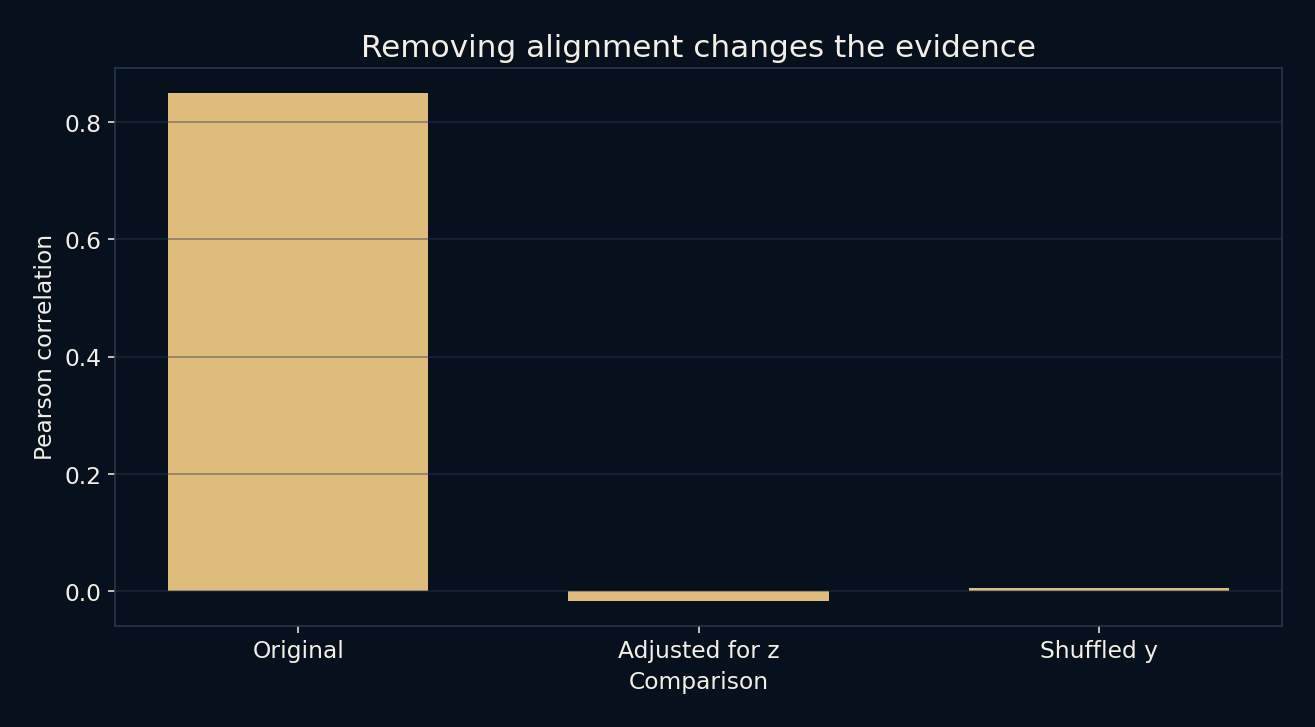
皮尔逊相关系数在考虑各变量尺度后,概括线性关联。输入不是常量时,它介于负一和一之间。本例原始样本相关约为 0.8494,说明这批生成数据具有很强的正线性模式。它不表示存在因果关系的概率为 84.94%,也不表示让 x 增加一个单位,就会让 y 增加 0.8494 个单位。
这个系数也不能发现所有关系。明显的曲线模式可能只有很小的线性相关,少量异常点也可能大幅影响样本系数。同时看散点图和数字,有助于描述测量到的现象;但两者都不会自动补齐信息,告诉我们哪种干预会改变哪种结果。
已知生成式还能在抽样前计算总体系数。独立性给出Var(x) = 2² + 1 = 5、Var(y) = 3² + 1 = 10,以及Cov(x, y) = 2 × 3 = 6。因此总体相关为6除以50的平方根,约0.84853,接近但不同于实测0.84938。y对x的总体回归斜率为6/5,即1.2;然而在这个世界,只改变x对y的效应为零。回归斜率与干预效应并不必须是同一个数字。
减去由 z 拟合出来的线性部分
接着分别用 z 为 x、y 拟合一条直线,每个拟合都包含截距。从各观测值减去对应的拟合值,剩下的部分叫残差,也就是这条拟合线未能解释的部分。计算两组残差的相关,得到约 -0.01591。在这个有限样本里,它接近零,但不恰好等于零。
如此大的变化与已知构造一致:共同的线性成分被减去,主要剩下独立噪声。这是在刻意有利的设定里演示调整,不是一套能从未知数据自动找出正确控制变量的程序。对于真实研究,仅凭残差相关很小,也不能证明不存在因果效应。
相同数值,换了行就换了故事
另一项比较把原始 y 值随机打乱,同时让 x 保持原位。每个 y 值都还在,所以这一列的分布和均值没有变化,消失的是原先的逐行对应。此时相关约为 0.005705。它说明一个简单事实:关联取决于哪些数值被配在一起,而不只取决于各列单独是什么样。
这只是固定种子下的一次置换,不是完整的置换检验,也没有计算显著性。更重要的是,打乱数据不等于随机分配 x 后再观察新的结果。它改变的是已记录的配对,而非测量的生成机制。在表格里破坏关联,不能解释现实中原来的关联。
把所有变量都控制住,不是因果策略
真实数据不会附带可信的生成方程。重要共同原因可能没有测量,测量存在误差,或以非线性方式关联结果。应该调整哪些变量,取决于所问的因果问题和假定的关系。收集更多列,并不等于已经识别了这些关系。
调整也可能去掉原本想测量的一部分效应,例如控制了影响过程中的中间结果。对两个变量共同导致的后果进行条件限制,还可能制造关联,而非消除关联。因此,控制所有可用变量并不是安全的通用建议。在拟合回归之前,需要考虑研究设计、领域知识和明确的假设。
两个世界,可以画出同一种点云
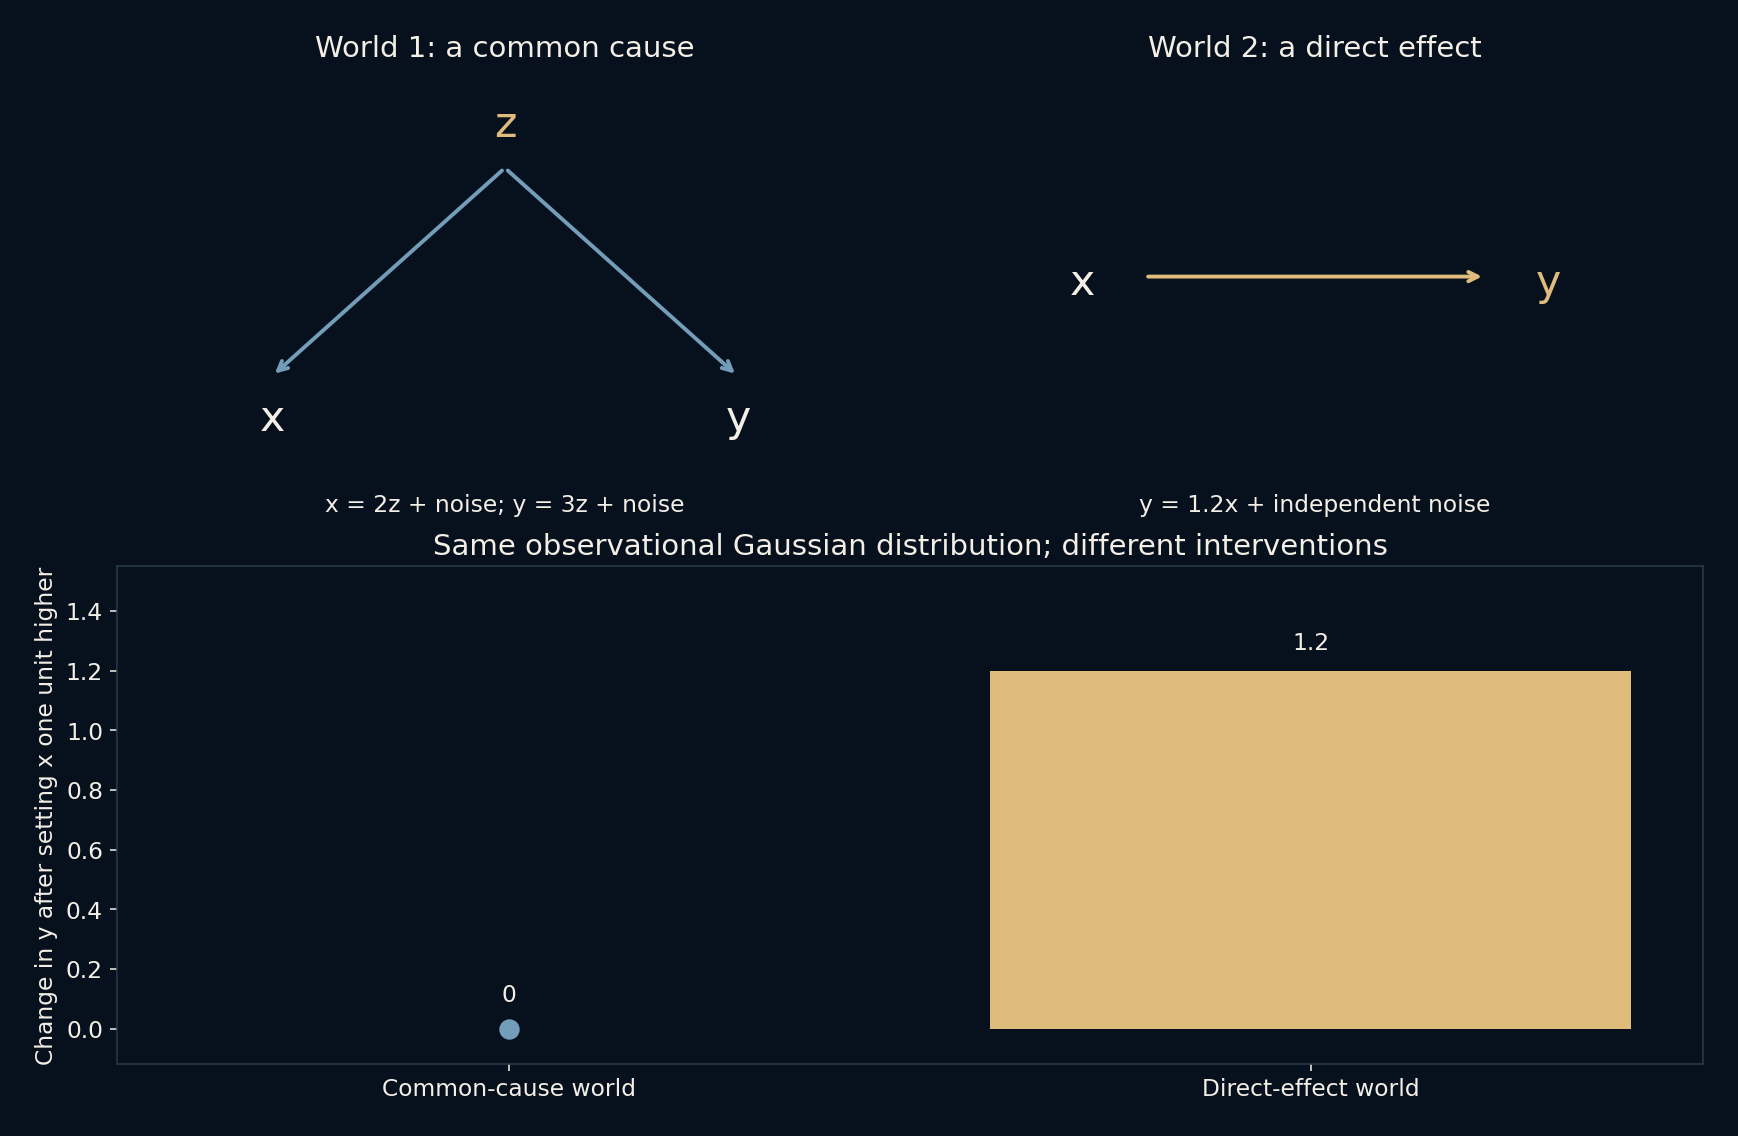
再建立第二个世界:x服从均值零、方差五的正态分布,y等于1.2x加独立正态噪声,噪声方差2.8。这里x确实进入y的生成式。然而,可观察的二元联合高斯分布与共同原因世界完全相同:均值都为零,方差为五和十,协方差为六。均值与协方差决定联合高斯分布。这里说的是分布相同,绝不是两次随机样本逐点一致。
接着分别在模型内干预:保持其他外部成分不变,让x增加一。共同原因世界的y方程根本不读取x,所以每个y不变;直接效应世界每个y增加1.2。脚本检验两种响应及两个可观察协方差矩阵。只收集这两个变量,即使再多观察数据,也不能仅凭分布区分这两个设定世界。要选择干预解释,需要实验、额外有根据的知识或不同证据。结论来自明写的模型,而不是从散点图发现了因果。
把观察与解释分开
看到令人信服的关联,先问每行代表什么、观测如何被选入,以及哪些测量被配在一起。再问真正提出了什么主张:描述共同变化、预测另一个数值、估计干预效应,是不同任务。一个有用的预测模式,未必能正确回答干预问题。
本地检查验证行数对齐、残差与 z 的正交性,以及本构造预期的原始相关较强、残差相关较小。这些是实现性质和特定演示的检查,不是因果识别。启发并不是不信任任何相关,而是让相关系数做好自己的工作,不让一个数字背负证据尚未建立的解释。