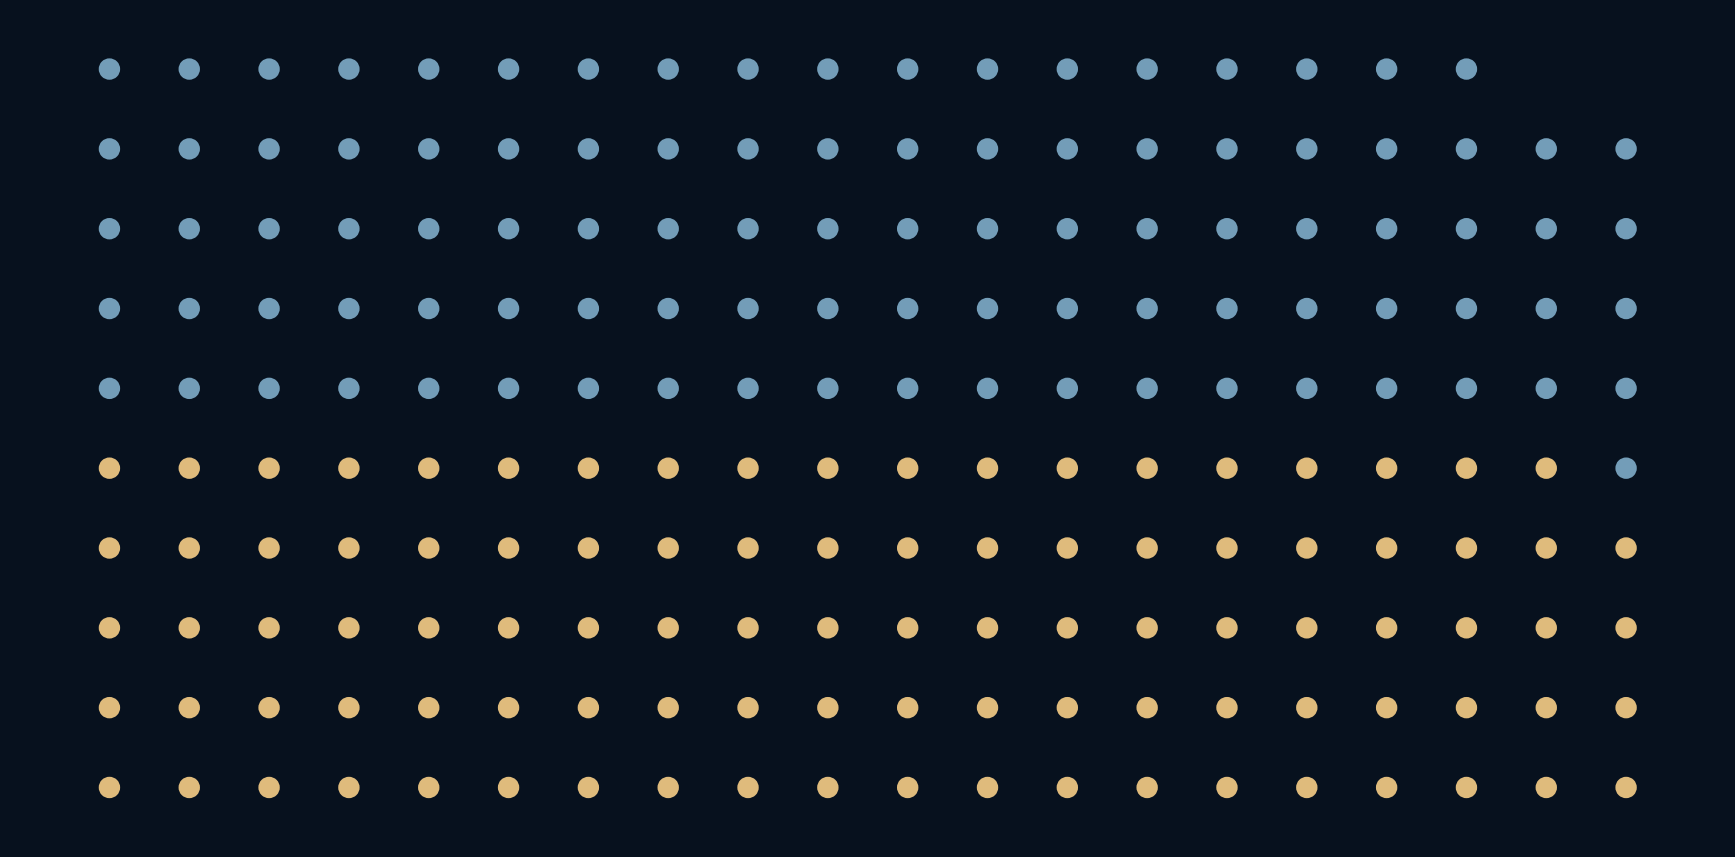
抓住99%的事件,也可能同时发出一样多的误报。
假设虚构检测器检查10,000个案例,其中100个确实存在目标事件。它能发现其中99%,对无事件的案例也能99%保持安静。两个比例都令人放心,但看看警报收件箱就会发现:只有一半警报对应真实事件。
警报的含义,也继承了目标事件的稀有程度。
先问比例的分母是谁
灵敏度问真实事件有多少触发警报,特异度问无事件案例有多少保持安静。两者都没有直接回答收到警报时的疑问:警报里有多少是真的?最后这个比例以全部警报为分母,而非事件组或无事件组。
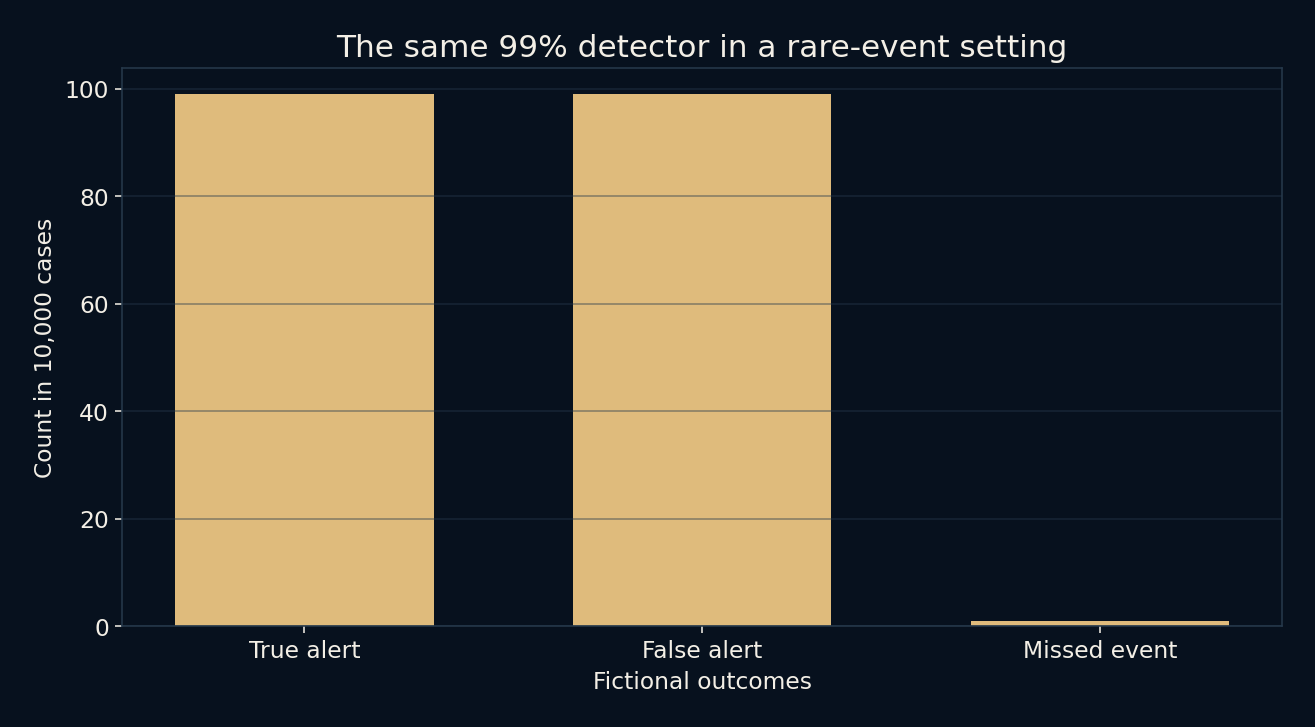
本例有100个事件、9,900个非事件。99%灵敏度产生99次真警报和1次漏报。99%特异度意味着无事件大群体中的1%仍会报警,于是也产生99次误报。同一个错误比例,作用在了大小非常不同的群体上。
打开警报收件箱
总共198次警报,99真、99假,99除以198等于50%,通常称为阳性预测值。它与99%的灵敏度、99%的特异度完全相容,因为各自条件和分母不同。
9,801个正确安静的案例仍然有价值。检测器并没有因此突然无用,本例也不能决定是否值得使用。那取决于警报成本、漏报成本和后续处理。在某种场景中复查很便宜,在另一种场景中却可能造成很大打扰。
越罕见,误报越显眼
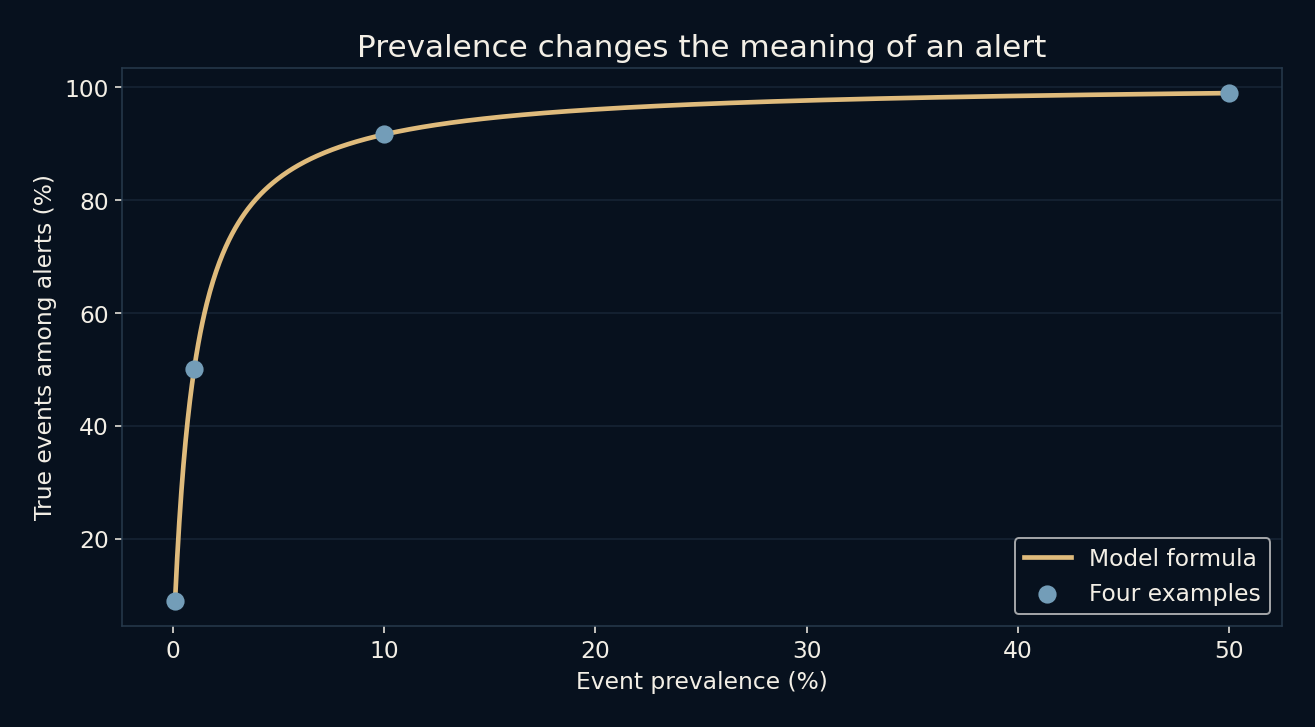
保持两项性能参数都是99%,但把事件发生率降到0.1%,警报中真实事件的期望占比就降到约9.016%。此时大多数警报都错了,尽管规定的检测率没变。发生率为10%时,真实占比约91.667%;为50%时,则为99%。
这些来自概率公式,不是四项现场研究。分子是灵敏度乘发生率;分母再加上误报率乘一减发生率。先讲清数量故事,公式就不神秘:真警报和误报都进入同一个收件箱,却来自大小很不一样的来源。
响铃之后应当做什么
合理做法是结合情境理解,而非盲信或一概忽略。现实决策可能需要第二类证据、认真复查或明确升级流程。这里的检测器和事件都是虚构的,没有实际后果,因此不指定处理方案。
重复检测也不会自动按简单倍数增加把握。若两个检测器共享数据或失效机制,错误可能相关,第二次报警提供的新信息也可能有限。原计算依赖指定群体和性能参数,改变流程就需要重新检查假设。
现实里的性能参数也有误差
为了凸显分母问题,这里的参数被当作精确输入。现实中灵敏度和特异度来自样本估计,还可能随场景变化。实际受检对象的发生率,也未必与参考数据一致。三项输入的不确定性都会影响答案。
所以不能把50%直接套到医疗检测、反欺诈系统或个人警告。能迁移的方法是询问每个百分比来自哪个群体,再还原预期数量。很小的误报比例,遇到足够庞大的背景,也能形成一大堆误报。