没有哪一个点知道自己属于一颗行星,但它们合在一起,把行星画了出来。
规则简单得有些出人意料:源图越亮的地方,得到一个点的机会就越大。把这个选择重复成千上万次,一个有明暗的球体和一圈细环便会浮现。每一次选择都是随机的,整体方向却经过了精心安排。设计就藏在概率里。
随机可以遵循一个计划,同时保留自己的不规则。
机会相同,注意力就平均分配
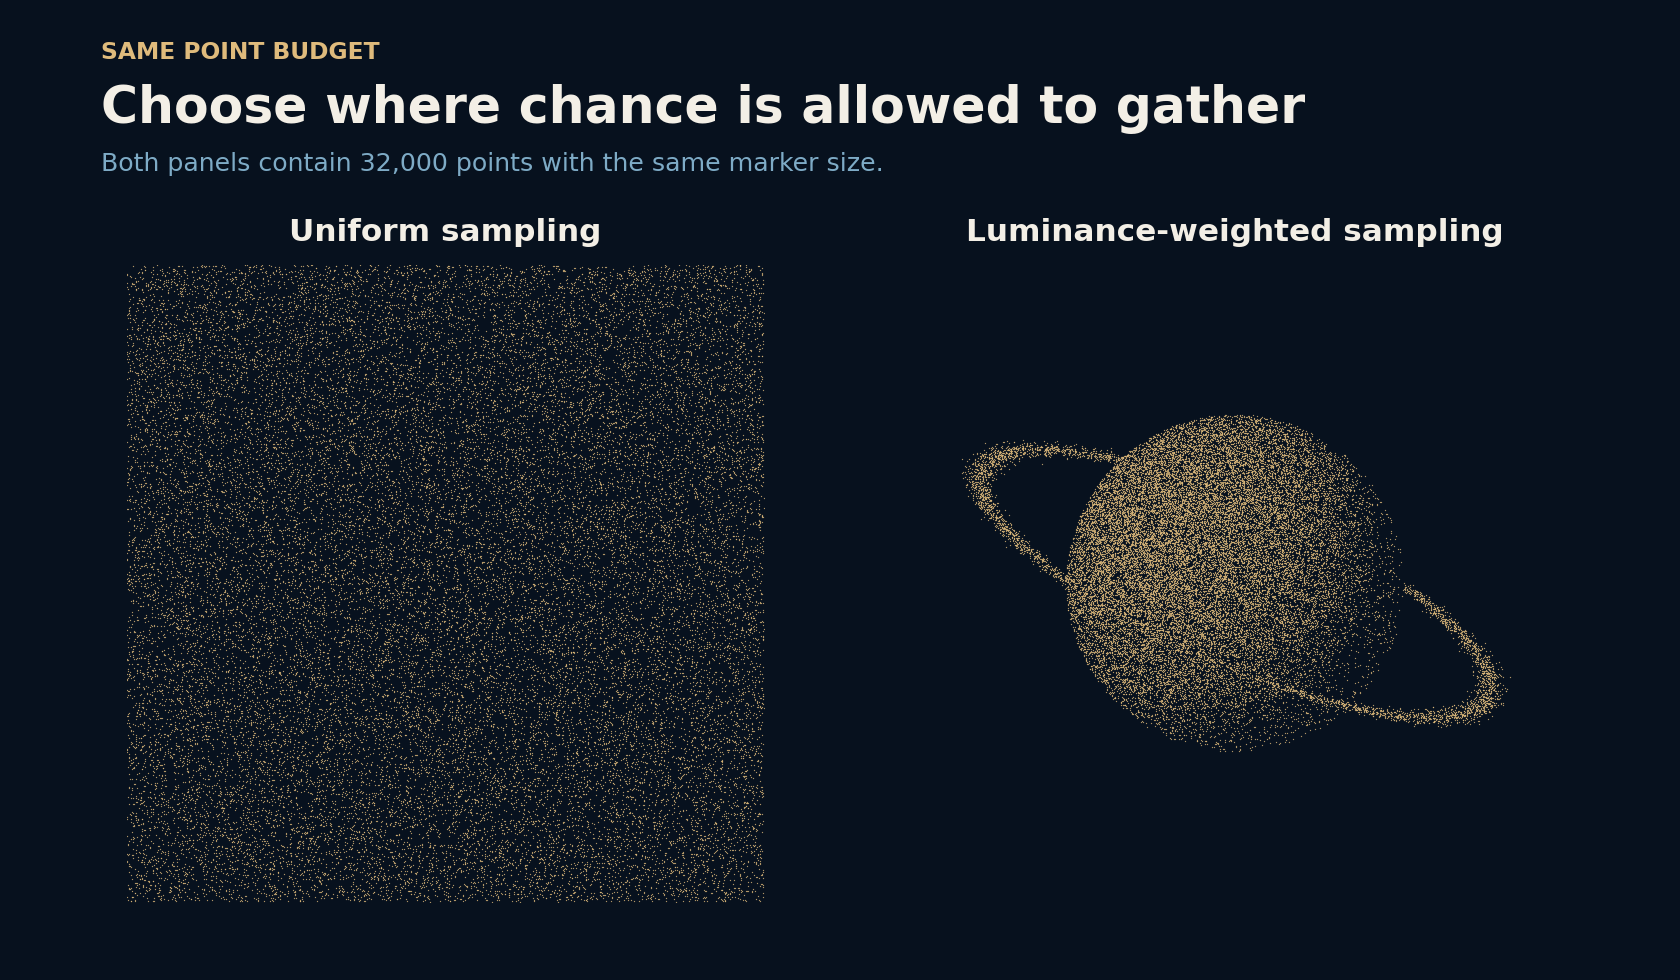
把点均匀撒在一个正方形里,每块等面积区域得到的点数期望相同。有些地方偶然更密,有些更疏,但整片点云没有理由自行组成一颗行星。均匀采样图与加权采样图都使用32,000个点,点的大小也一致,区别只是这些点更可能在哪里聚集。
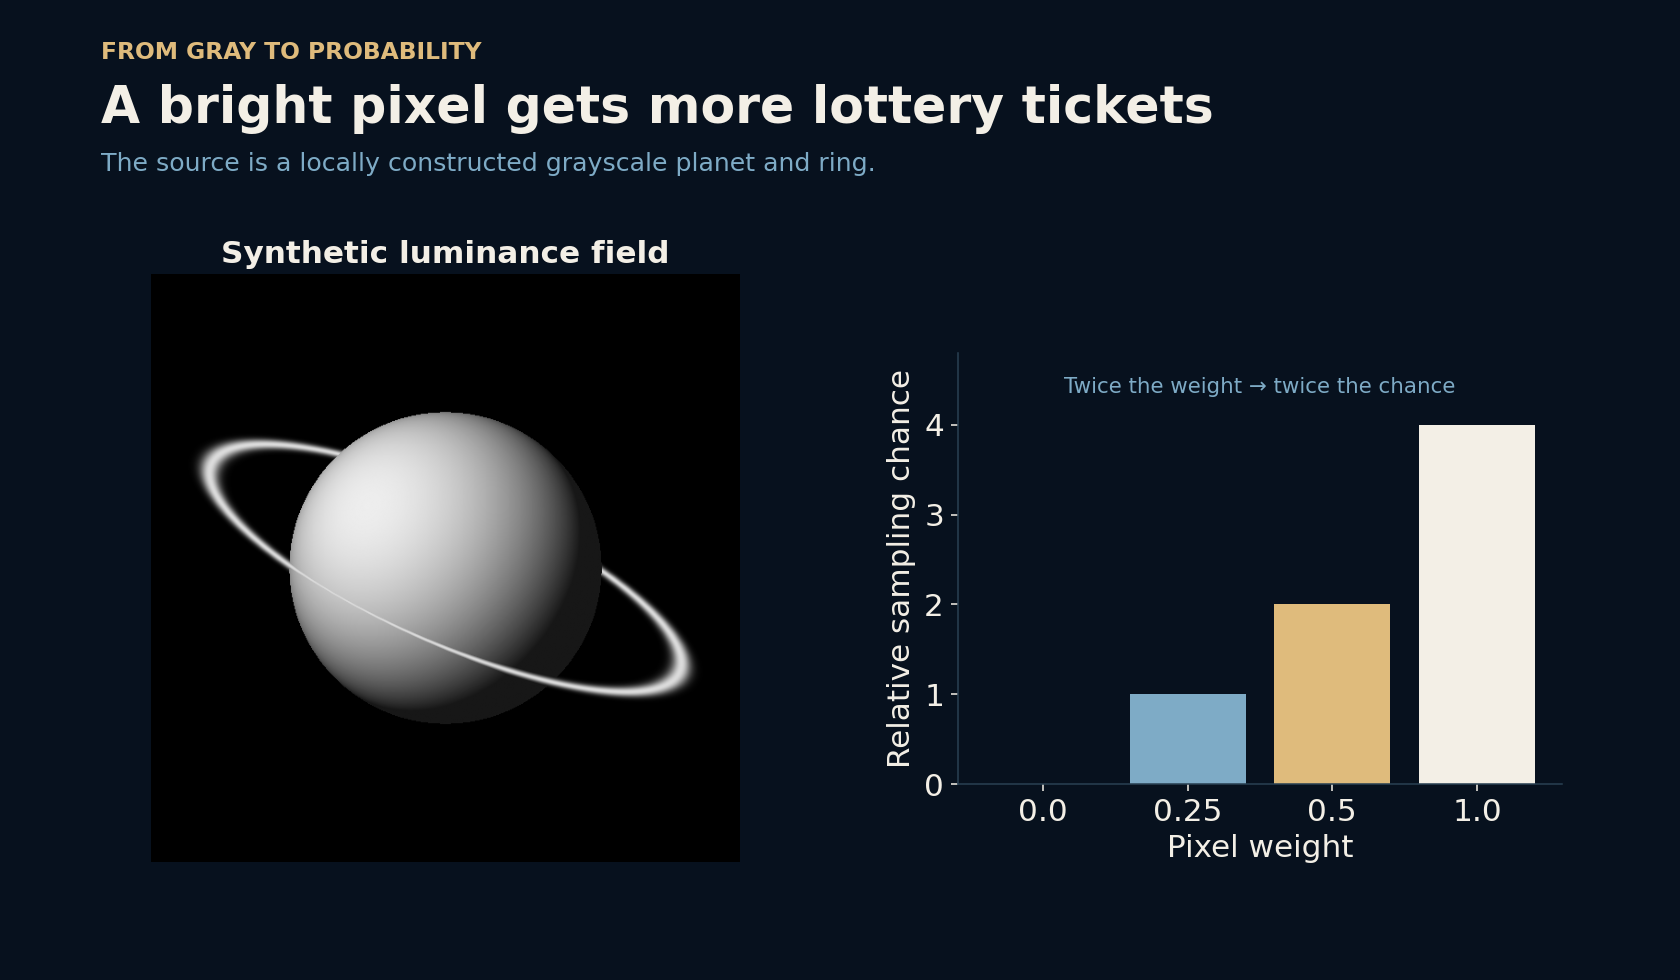
目标图在本地构造:一个带有明暗的圆形球体,加上一条椭圆环。它是一张刻意设计的灰度场,并不是从隐藏信息中恢复出来的照片。
把亮度变成抽签机会
每个像素都有一个非负亮度权重。把该像素的权重除以所有权重的总和,就得到它被选中的概率。权重翻倍,被抽中的机会也翻倍。每次先抽取一个像素,再在像素内部随机加一点位置偏移,让所有点不至于整齐地卡在像素中心。
权重严格等于零,概率就是零:这种背景不会得到任何加权样本。环边缘虽然可能暗得在预览里看起来是黑色,只要权重仍为正,就依然有机会被抽中。源图的权重总和必须大于零;若输入全黑,就需要另行定义处理方法。本例的明亮球体和环确保了总和为正。
固定种子,让实验可以重来
随机不等于无法重复。本地测试使用伪随机生成器和种子2026。对同一个目标,按完全相同的过程再采样一次,得到的点坐标逐一相同。这样就能固定底层点集,只修改绘制方式,而不会把新随机结果造成的变化误当成设计调整的效果。
但种子并不是全部配方。生成器、输入场、采样方法、点数,以及调用随机数的顺序都很重要。我们的过程先有放回地抽取像素索引,再生成像素内部偏移。另一个实现即使用相同的种子数值,也可能得到不同图像。可重复性属于完整过程,而不只是那个好记的整数。
统计数字也看得出图像的轮廓
把权重大于0.15的像素定义为明亮前景。它只占画布面积的21.20%,却包含全部采样权重的97.14%。实际的加权抽样中,97.16%的点落在这里;均匀抽样则有21.33%的点落入,更接近前景的面积比例。
这些数字检验了预期机制:加权采样跟随亮度权重,均匀采样跟随面积。它们不能证明每一处细节都准确,也不能证明读者一定更喜欢这个结果。阈值只是为了划出一块便于统计的区域;采样本身不会用这个阈值切掉较暗的像素。
点更多,明暗也更容易浮现
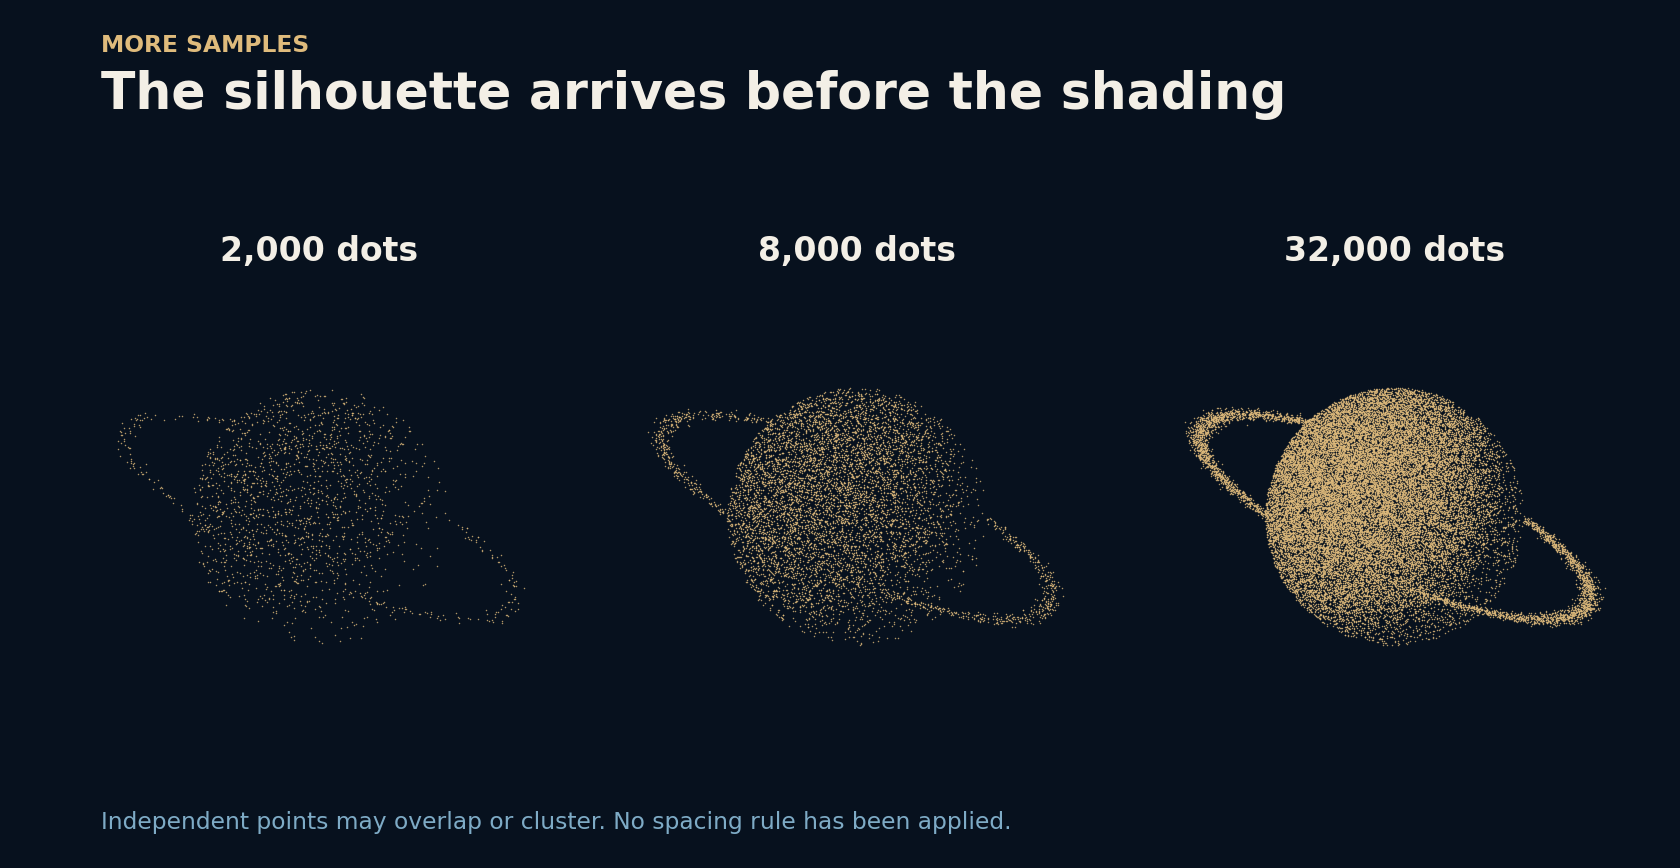
只有2,000个点时,轮廓已经出现。增加到8,000和32,000个点后,分布更密,局部明暗也更容易辨认。把画面分为20 × 20的粗网格,统计每格点数,还能做另一项检查。在本次最少和最多点的结果之间,实测点数与目标权重分区总和的相关系数,从0.9728提高到0.9985。
这只描述当前目标和种子的结果,并不承诺每增加一个点,画面都会更好。图中固定了点的大小,所以增加点数也让物体看起来更亮。点的大小、不透明度、重叠与背景颜色,都会影响最终观感。让点的期望密度符合目标,与精确恢复原图亮度,是两回事。
结团,也是这种纹理的一部分
有放回采样允许同一个像素被选中多次。独立的点可能靠得很近,也可能留下小空隙。这种颗粒感构成了画面的风格,但也可能遮住细线,或者让某个区域显得不均匀。本实验没有规定点与点之间的最小距离,也没有在采样后进行位置松弛。
其他点描方法可以让点分布得更均匀、改变点大小,或者反转权重,在浅色背景上画深色点。每种选择都会改变视觉语言,有时也会改变统计性质。这里真正有用的发现更简单:一张概率场,就能让随机成为一种可理解、可推敲的绘画材料。