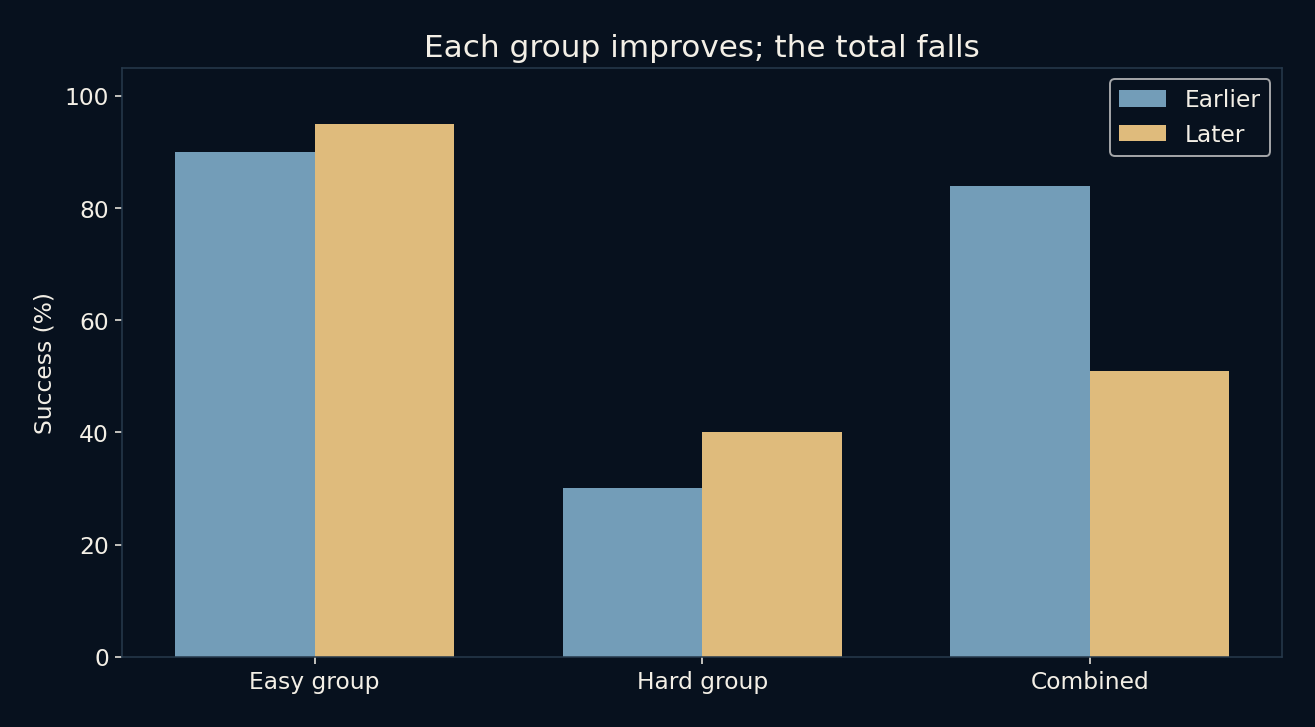
90变成95,30变成40,总体却从84变成51。
这些数字不是表格算错了。一个虚构服务处理容易和困难两类任务,两个时期之间,各组成功率都提高了,总体却下降。原因是后一期接到更多困难任务。总体百分比把对象构成也装了进去,只是通常不会主动告诉你。
每个总体比例下面,都藏着一组权重。
把分母一起留下
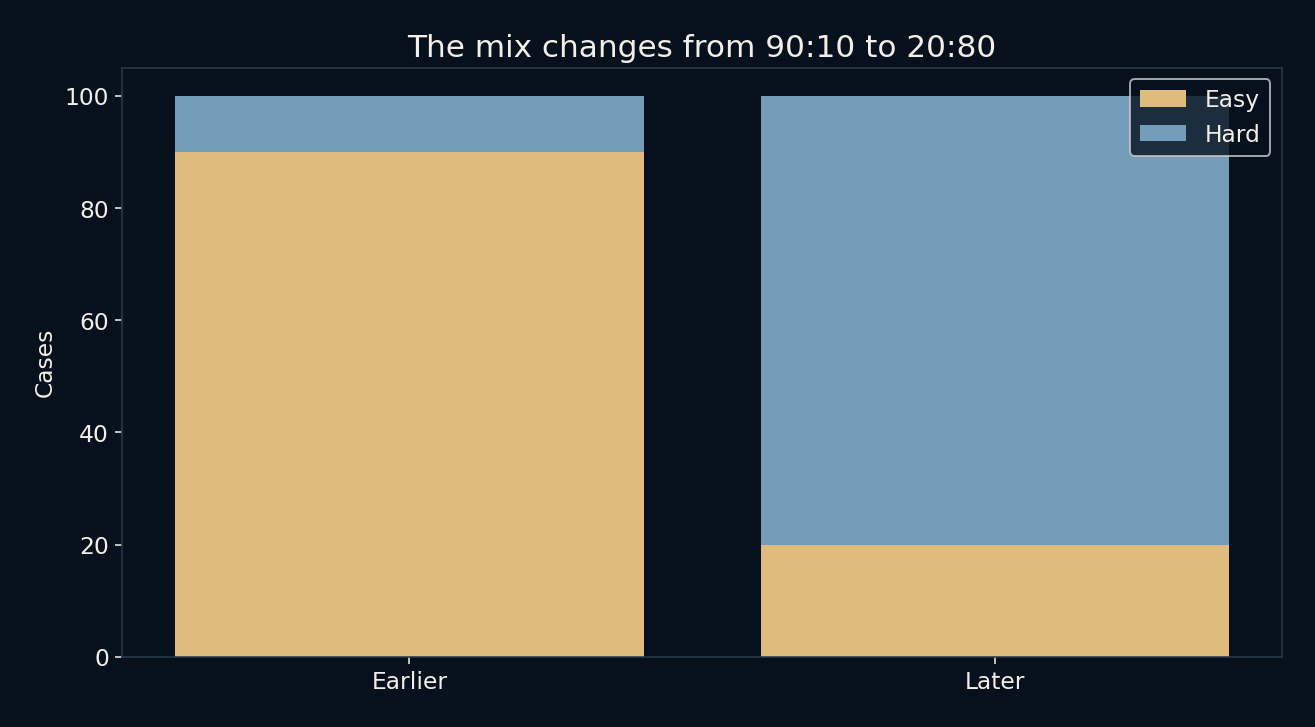
前一期,容易任务90件完成81件,困难任务10件完成3件,成功率分别90%和30%。合计100件完成84件,总体84%。因为容易任务占大多数,它的高成功率主导了总成绩。
后一期,容易任务20件完成19件,困难任务80件完成32件,两组成功率提高至95%和40%。但总共只完成51/100。容易任务减少,困难任务增加,这个算式并不要求任何一组退步。
总体是带权重的平均
前一期容易与困难任务的权重分别为90%和10%,后一期变成20%和80%。用各组成功率乘以任务占比,再相加,就能还原总体。这个百分比同时在描述表现和任务来源。
直接平均两组百分比,则回答另一个问题。等权重时,前期为60%,后期为67.5%。这相当于固定一半容易、一半困难的参考构成,显示该参考群体的改善,但并不是任一时期全部实际任务经历的成功率。
两个总结可能都重要
若想判断可比任务中的表现是否改善,可以看组内比例或说明清楚的标准化比较。若要安排后续处理,则后期实际失败的49件任务更重要。同一份数据能支持这两种关注,选择一种总结不会让另一种消失。
因此,给一个百分比贴上“更好”的标签,可能引发算术无法解决的争论:对哪个群体、哪种任务构成、什么决策而言更好?在奖励团队、比较系统或解释变化之前,应把分母和参考构成摆出来。
分组不自动等于找到真相
这是辛普森反转的一种形式,但看到反转不代表就知道应该控制哪些变量。现实中的分组因素可能解释任务难度,也可能是决策的后果,或引入新的选择问题。必须了解数据怎样产生,才能判断它的作用。
本例的“容易”和“困难”由我们直接设定,没有随机分配任务的实验,没有隐藏差异的测量,也没有声称某项干预造成进步。这个计数表只隔离出一个数学机制。因果结论需要额外设计和证据,不是把表格分得更细就足够。
问百分比以外还有什么改变
实际阅读时,先索取成功数和总数,而不只看百分比。再比较前后各组人数,若决策需要,可计算固定构成的指标。真实应用中的小组还需要不确定性估计:20件中完成18件变19件,不应被视为精确的总体改善。
这里的计数是精确构造的例子,并非从某个总体抽样得到的噪声观测,目的是让反转一目了然。可保留的阅读习惯是:当整体趋势与各部分矛盾时,先查权重,再找计算错误。有时总体描述的已经是另一群对象。