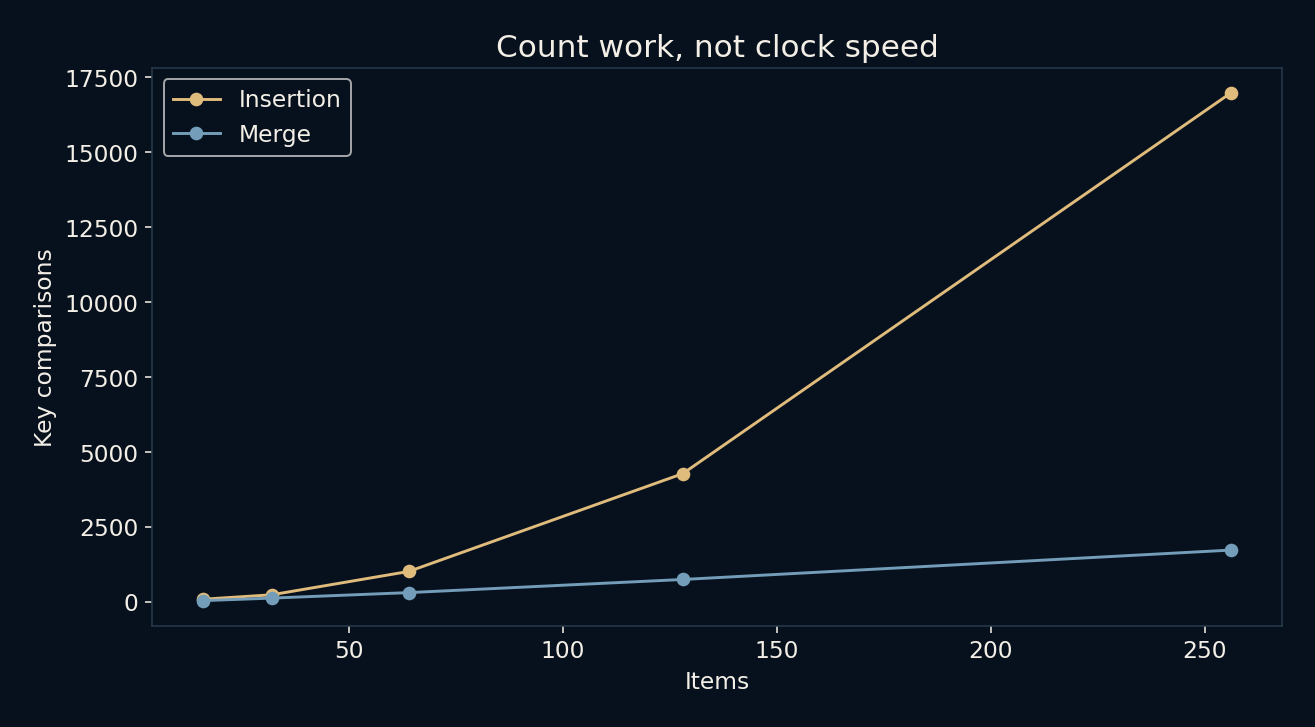
同样256个数,一种方法比较16,973次,另一种只需1,728次。
两段本地程序都排对了顺序,也没有谁使用更快的电脑。一种把新项插入已经有序的前半段,另一种拆分列表、分别排序再合并。这是算法设计的具体例子:我们只计量一种明确工作,不宣称实测提速。
好算法能让机器少回答一些问题。
像整理手里的牌
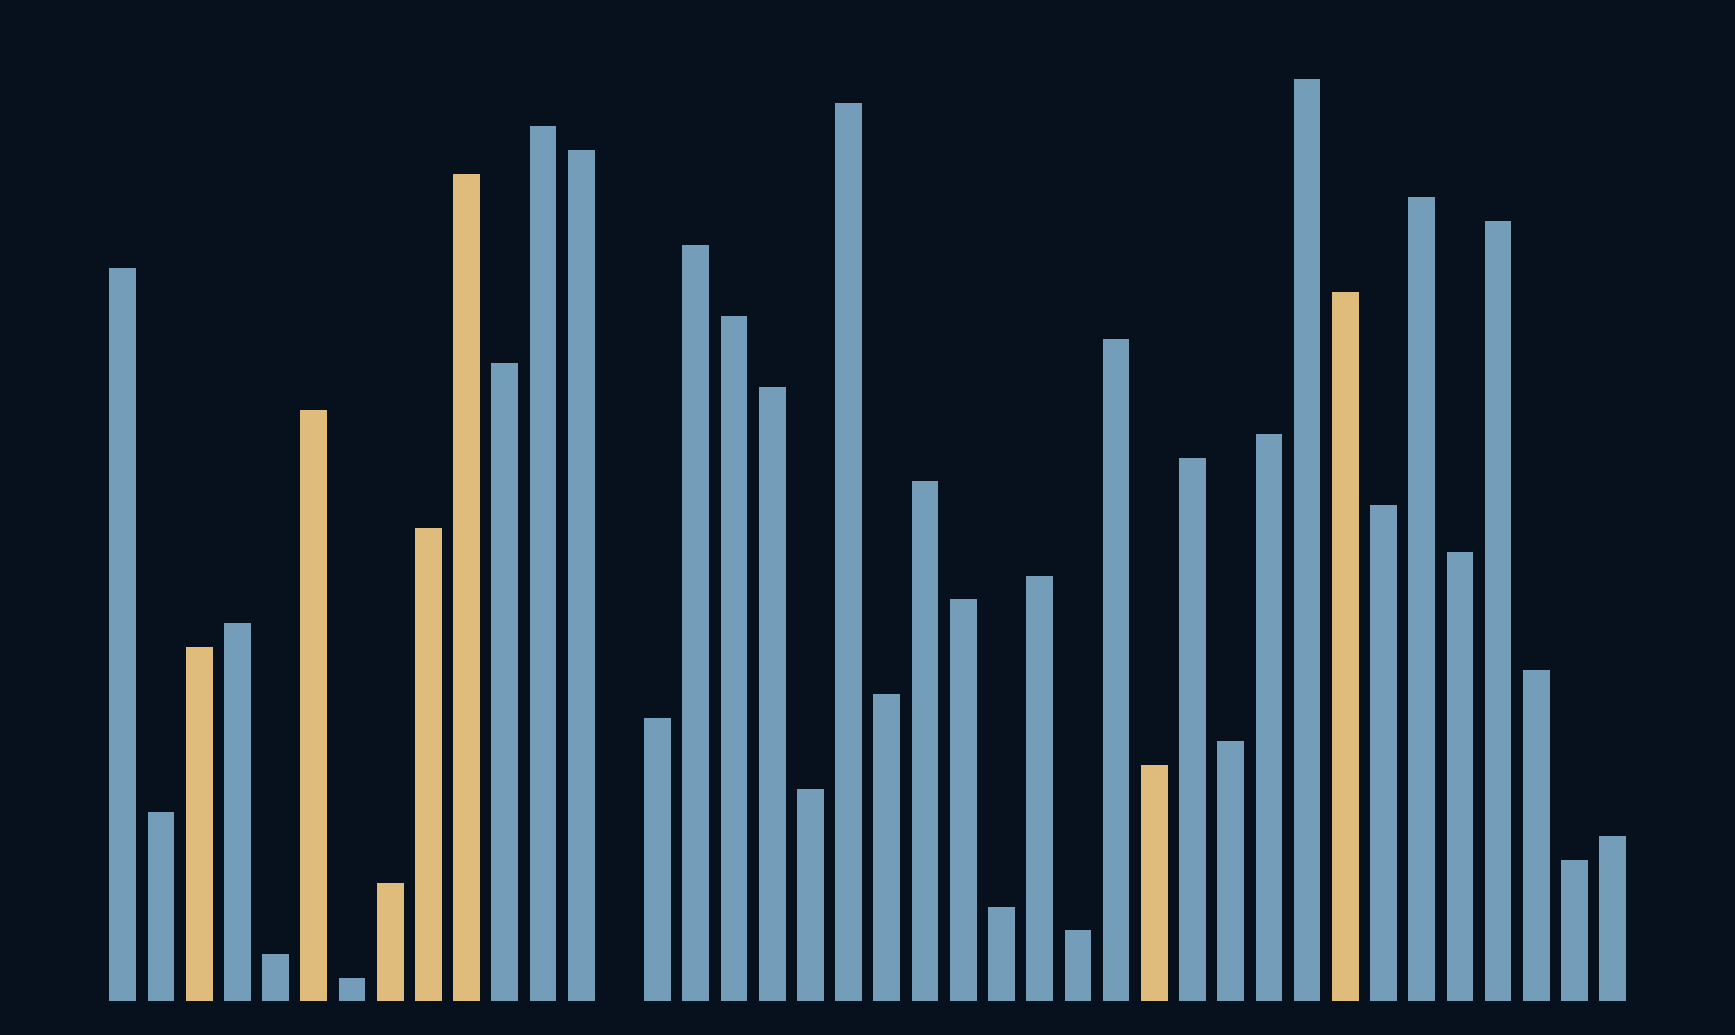
插入排序像整理带数字的手牌:拿下一项,与左边已有项比较,把较大者移开,直到找到位置。每次插入后,前面一段都有序。如果输入本来就很友好,它可以只做很少工作。
计数器在新键与已有键比较时增加,不把循环边界检查算作键比较。移动数值、复制列表和分配内存也没算进去。先定义单位很重要,否则两张写着“操作数”的图可能完全不是同一种测量。
有序的两半更好商量
归并排序不断把列表分半,直到片段足够简单,再比较两个有序片段当前的首项,把小者放进输出,并推进那一边。某一边用完后,另一边剩余内容可直接复制,不必再比较键。
256个不同整数的固定随机排列中,归并比较1,728次,插入16,973次;16项时分别42和90。这是具体输入的实测次数,不是适用于所有列表的公式。两种结果都与精确的升序整数列表核对。
反复遍历与分层合并
逆序输入时,插入每个新键都要与前面所有键比较,n项共需n(n−1)/2次,256项就是32,640次。归并则经过若干拆分层,每层的合并工作分散到各项。这就是常见平方级与n-log-n增长描述的来源。
增长记号说明特定条件下成本怎样扩展,不是秒表读数。常数、表示和实现仍然重要。教学程序里比较少的方法,不自动成为每种小列表的最佳选择。关键区别是把每一步做快,还是规模变大时少做一些步骤。
已经排好序时,故事不同
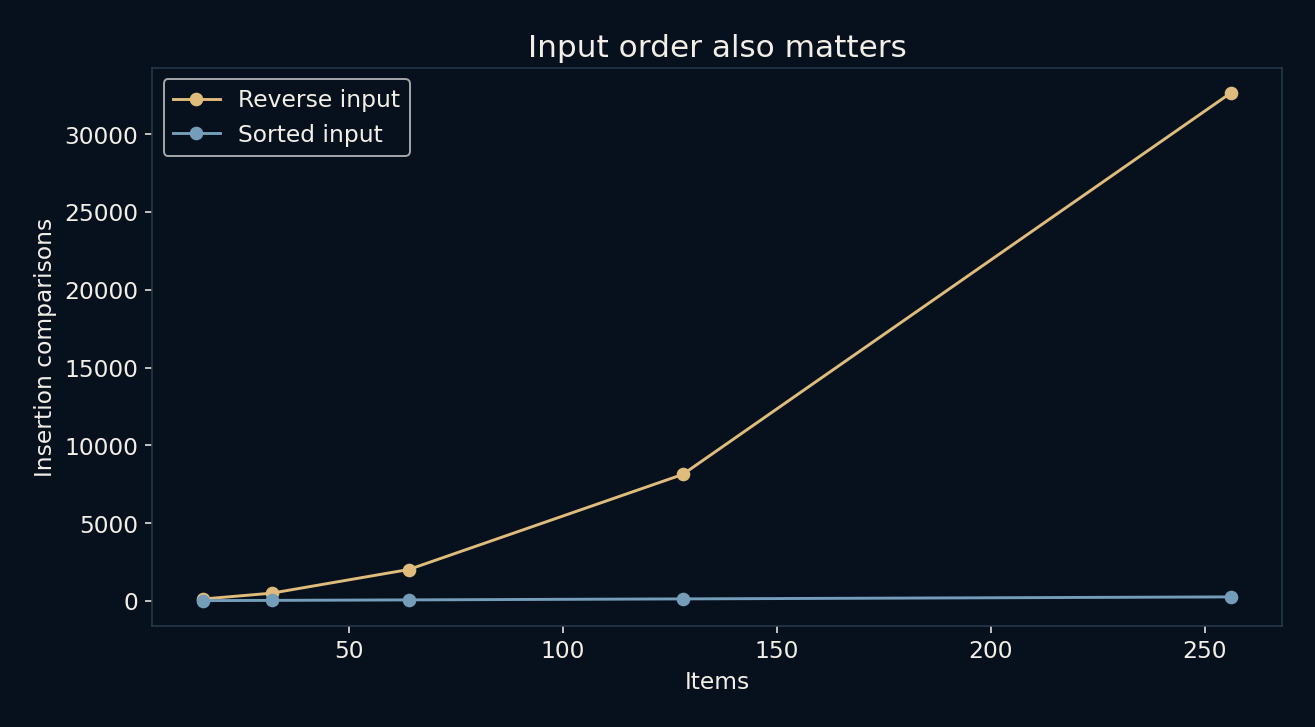
同一插入程序处理256项升序列表,只需255次比较,每个新项都立即放在前项后面;逆序却需32,640次。差距来自输入顺序,不是算法或硬件变化,一个“排序成本”数字会藏住它。
因此,实验把升序和逆序与固定随机排列分开绘制。随机例子使用不同整数,每个规模只抽一次,有助比较本次实现,但不是所有排列的穷尽平均研究,也不能代表大量重复项的应用数据。
比较不是全部账单
生产排序还要考虑内存、移动、昂贵比较函数、稳定性和部分有序结构。Python内置排序是经过优化、具有适应性的稳定实现,并非这里的两段教学程序。图表不能成为替换它的理由,我们也没对内置排序计时。
图表提供的是在购买算力前先问的问题:系统是否重复了本可避免的工作?重组问题能否减少重复?之后仍要测量真实负载,包括计数器省略的成本。算法想法只有在核算与实际任务一致时才真正有用。