11个观测值平均72.73,其中10个却都小于43。
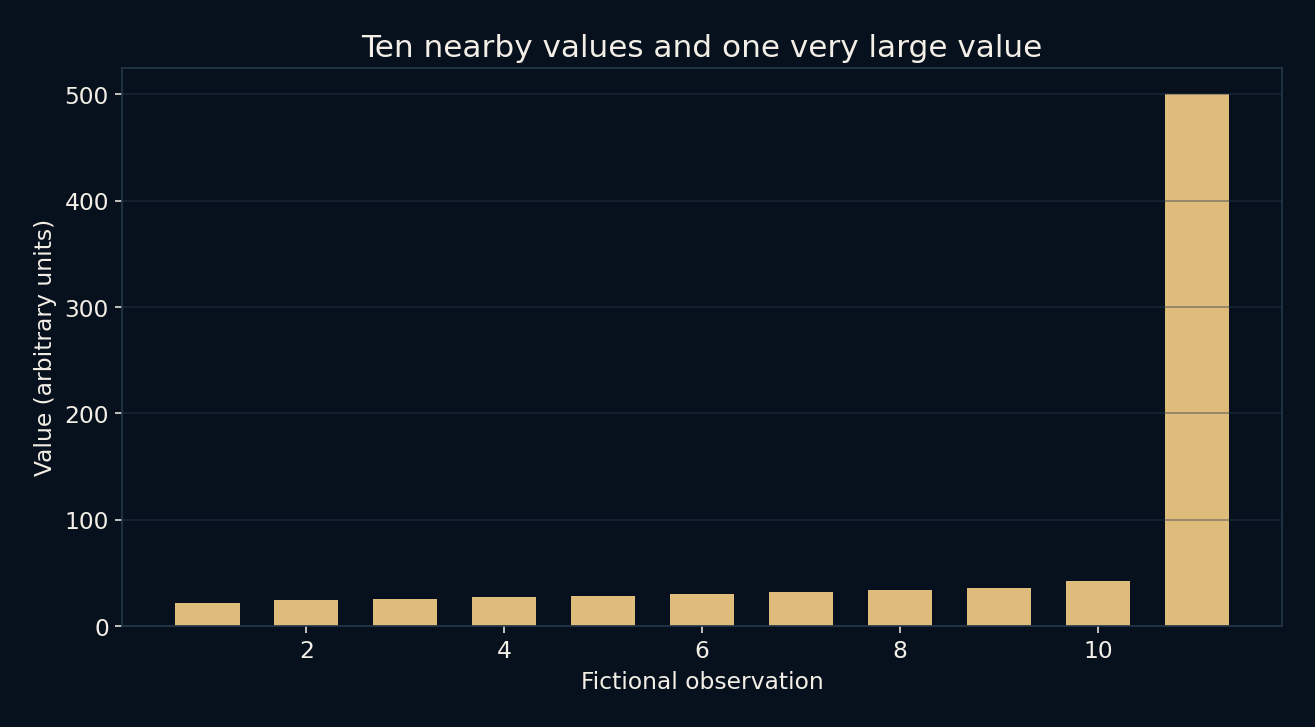
这份虚构列表从22、24、25、27、28、30、32、34、36、42开始,最后出现500。单位是任意的,不代表工资、房租或人群测量。刻意制造的反差,让我们看见三个常用指标如何总结同一份数据,以及哪个更有助于读者想象列表。
选择总结方式,就是选择保留什么。
平衡点被拉走了
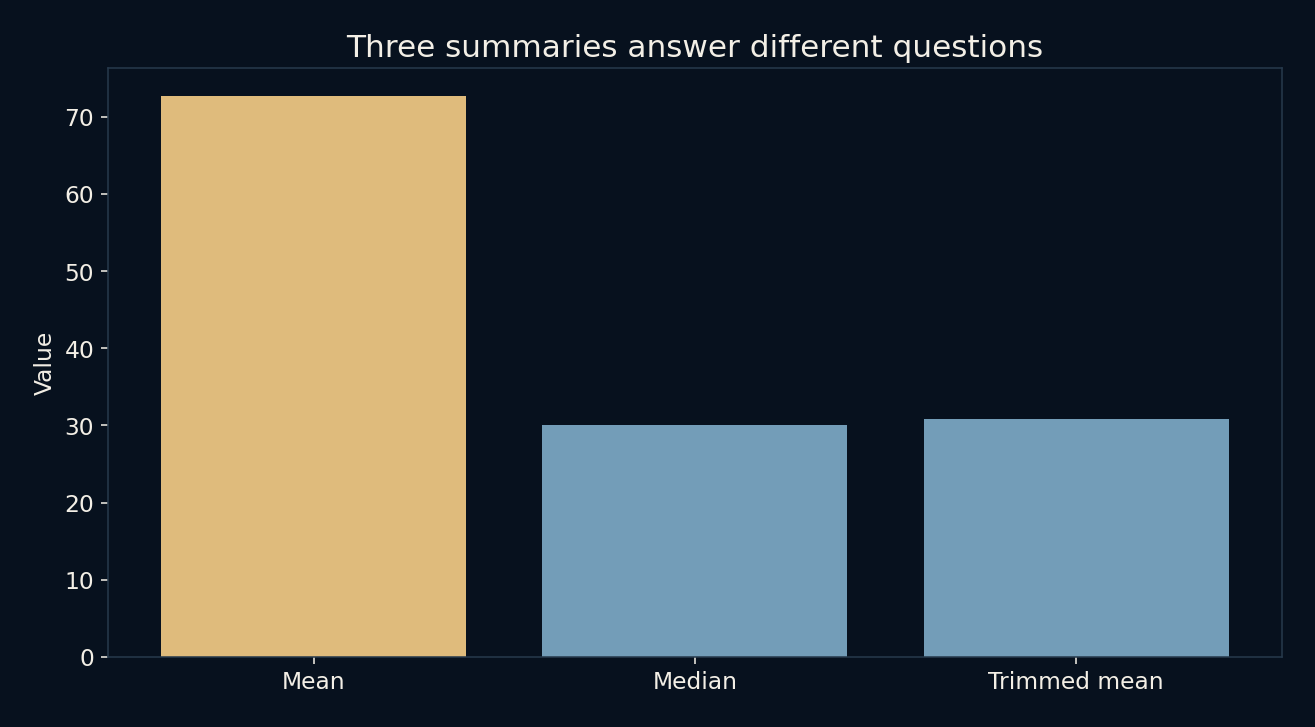
11个数相加为800,除以11得到算术均值72.7273。这个算法保留总量:11份相同的均值加起来仍为800。因此,它适合核算、预期总量,以及数量在整体上怎样分配的问题。
但没有一个观测接近72.73。十个都在22到42之间,另一个为500。移除最后这个数,前十个的均值恰好是30。这不是计算失败;大值本来就对总量贡献更大,均值的设计正是保留这种信息。
排序后找中间
中位数问的是排序后哪一个位于正中。11个值的第六个是30,前后各有五个位置。只要中间的次序不变,即使把500改成5,000,中位数也不会动。
描述偏斜分布中的典型位置时,这种稳定性很有用。但它有意舍弃一些信息。只看中位数,分不清上尾结束于50还是5,000。若关心总负担或总资源,这个被省略的差别可能最重要。
截尾均值需要公开规则
实验还恰好移除一个最小值和一个最大值,再平均剩下九个。它们合计278,截尾均值为30.8889。这是为例子预先选定的对称规则,不是在统计上宣判22和500是错误。
截尾能降低极值影响,又比中位数保留更多中间数据,但截多少仍是建模选择。看见不方便的结果后才决定删除,会悄悄改变问题。好的报告会说明规则,并保留未经截尾的总结。
典型和总量不是同一种需求
若需要一个代表这份列表普通位置的数字,中位数更贴近密集的中间;若要把总量平分,均值给出正确份额。宣布某个指标永远更好,对这两个任务都没有帮助。用途决定压缩数据时应该保留什么。
分布图常常是最简单的补充,能展示单个数字隐藏的空隙、聚集和孤立值。真实数据还应报告样本量和离散程度。两组可以中位数相同而尾部不同,也可以均值相同而典型体验差异很大。
不寻常不自动等于无效
远离其他值的点值得调查,而非自动删除。它可能是输入错误、单位不同、另一类对象,也可能是真实的罕见观测。不同解释需要不同处理:单位错了应修正,有效的大值则可能必须保留,即使它让总结不那么舒服。
本例的500是故意放进去的,无法替真实情境判断原因。它的作用是把运算与判断分开。在说“平均的人”或“平均案例”怎样之前,先检查这个数是在描述中间、保存总量,还是试图同时做两件事。