95%의 시간 동안 바쁜 서비스에서는 한 번의 처리 시간보다 훨씬 오래 기다릴 수 있다.
직원 한 명인 가상 창구를 생각하자. 작업은 평균 한 시간 단위가 걸리지만 매번 다르고 도착 간격도 변한다. 고장도 없고 장기 도착률은 평균 처리 능력보다 낮다. 그래도 줄은 길어질 수 있다. 평균 업무를 처리할 수 있다는 것과 모든 몰림을 즉시 흡수한다는 것은 다르다.
여유 용량은 대기열이 회복할 시간을 준다.
두 가지 불규칙성
실험은 도착 간격과 서비스 시간에 서로 독립인 지수분포를 쓴다. 평균 서비스 시간은 임의의 한 단위다. 이용률은 도착률을 처리율로 나눈 값이며 정상 상태 모형에서 0.5는 절반의 시간 동안 바쁘다는 뜻이다. 도착 순서대로 처리하고 중간에 떠나는 작업은 없다.
새 작업은 남은 처리와 앞에 쌓인 작업을 기다린다. 그 적체가 사라지기 전에 다음 작업이 올 수 있다. 한산한 때는 줄이 줄고 몰리는 때는 다시 쌓인다. 이 변동이 핵심이다. 간격과 처리 시간을 모두 일정하게 바꾸면 다른 시스템을 설명하게 된다.
마지막 몇 퍼센트의 큰 비용
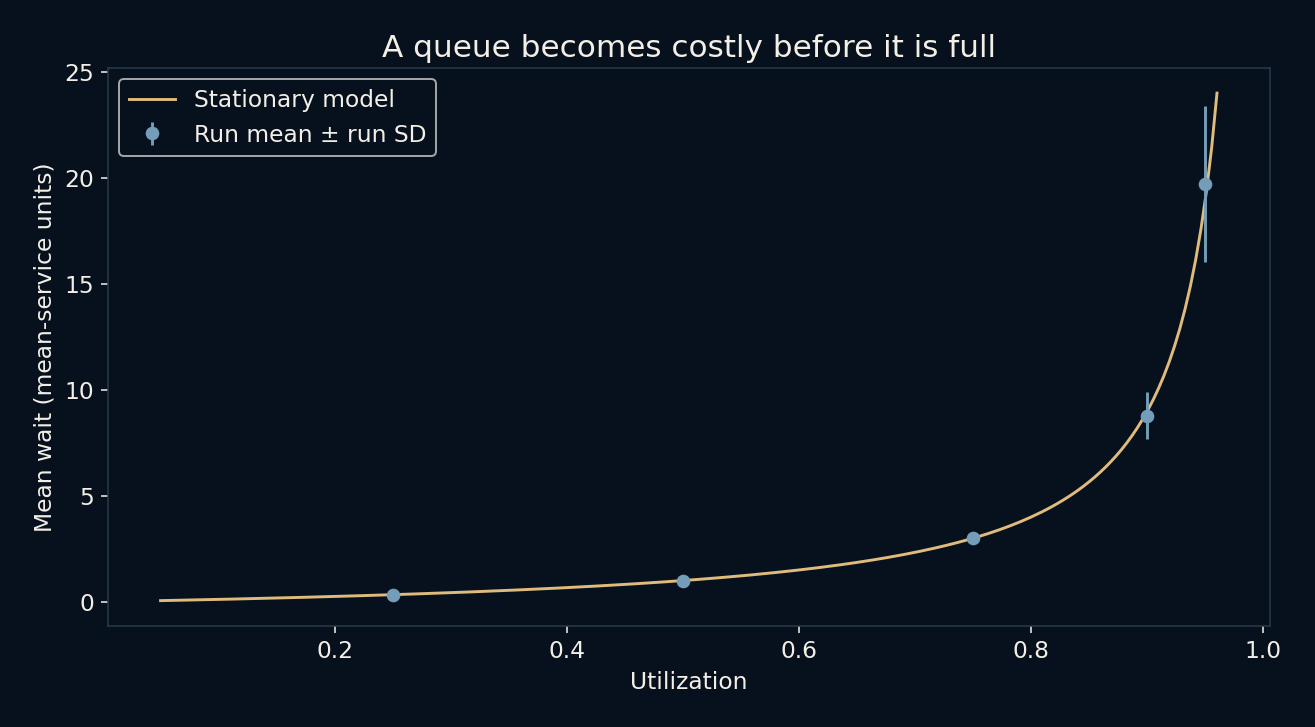
이 이상적인 정상 상태 모형에서 서비스 전 평균 대기는 이용률을 1에서 이용률을 뺀 값으로 나눈 것이다. 평균 서비스 시간 단위로 50%에서는 1, 75%에서는 3, 90%에서는 9, 95%에서는 19다. 서비스 자체는 빠져 있으므로 총 체류 시간에는 평균 서비스 시간을 더해야 한다.
시뮬레이션은 같은 부하에서 0.996, 3.001, 8.775, 19.728을 측정했다. 곡선은 따르지만 정확히 일치하지는 않는다. 이용률이 90%에서 95%로 조금 높아지면 이론적 평균 대기는 두 배 이상이 된다. 남은 작은 회복 여유가 상당한 역할을 하는 것이다.
평균은 고르지 않은 경험을 숨긴다
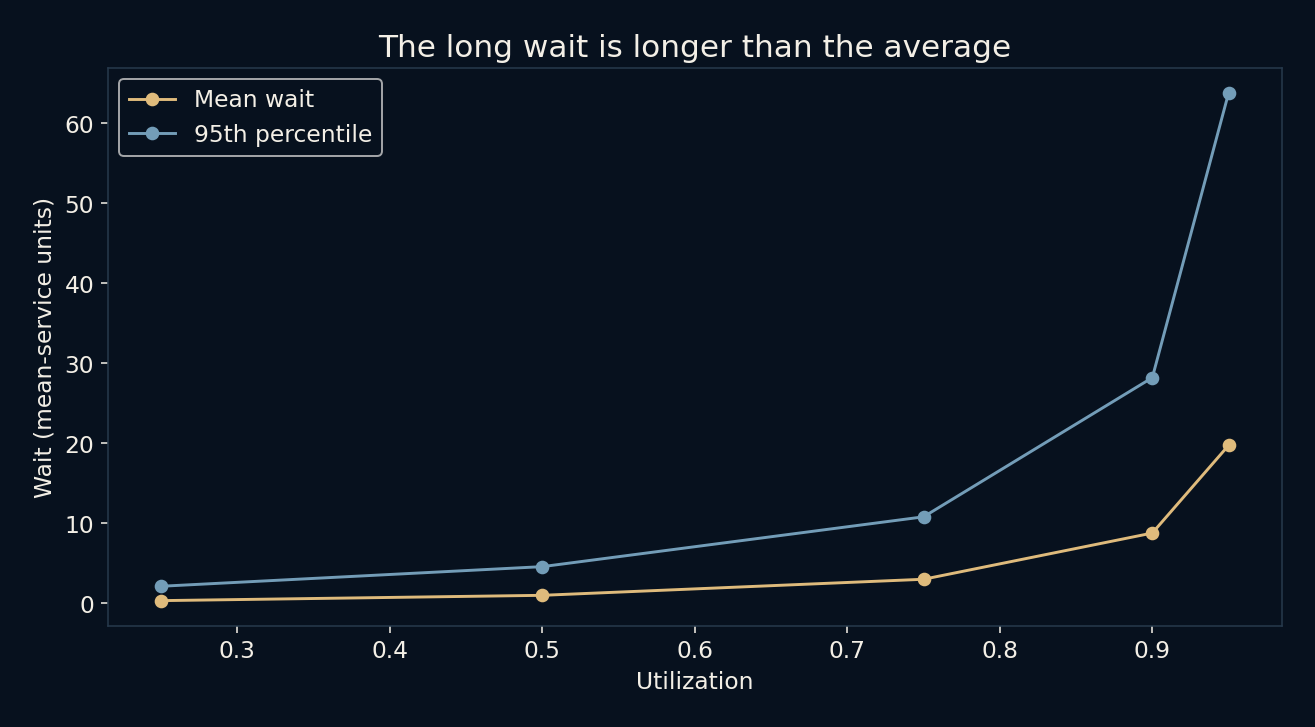
평균 19단위라고 모두가 19단위를 기다리지는 않는다. 빈 창구에 도착하면 대기가 0이고 긴 혼잡에 들어서면 훨씬 오래 걸린다. 95% 이용률에서 모의 95백분위수는 약 63.734단위였다. 합친 보존 표본 중 대략 스무 번에 한 번은 이를 넘었다.
50%에서는 평균이 약 1인데 95백분위수는 약 4.579였다. 백분위수는 평균과 다른 경험을 보여 주지만 역시 유한 데이터의 추정치다. 드물게 긴 혼잡이 생기면 평균과 꼬리 모두 바뀐다. 높은 부하일수록 이 문제가 커진다.
빈 상태에서 시작하는 이점
모든 창구는 빈 상태에서 출발한다. 바로 측정하면 장기 운영 중인 대기열에는 없는 일시적 이득을 준다. 따라서 매번 첫 10,000회 도착을 버리고 50,000회의 대기를 기록했다. 부하마다 12회 독립 실행해 곡선 하나가 숨길 수 있는 변동을 드러냈다.
준비 구간을 버렸다고 이후가 완전한 정상 상태임이 증명되지는 않는다. 95%에서 실행별 평균의 표준편차는 약 3.678로 가벼운 부하보다 훨씬 컸다. 같은 줄의 연속 대기는 적체를 공유해 서로 의존한다. 모두를 독립 관측으로 다루면 정보량을 과장하게 된다.
유용한 경고이지 인력 계산기는 아니다
현실에는 여러 직원, 우선순위, 예약, 묶음 처리, 휴식, 떠나는 고객이 있을 수 있다. 도착이 함께 몰리고 처리 시간 분포도 다를 수 있다. 이런 조건은 수식과 대응을 바꾼다. 이 숫자는 웹사이트, 병원, 가게, 상담 센터의 실측이 아니다.
옮겨 갈 만한 것은 원리다. 수요가 흔들리면 바쁜 시기 뒤에 회복할 여유가 필요하다. 실제 업무와 중요한 대기 경험, 특히 긴 지연을 함께 살펴야 한다. 높은 이용률은 효율적으로 보이면서 회복 여지를 거의 남기지 않을 수 있다. 적절한 목표를 이 모형 하나로 정할 수는 없다.
더 읽어 보기
MIT: single-server exponential queue model ↗NumPy: exponential sampling ↗NumPy: quantiles ↗공식 문서와 함께 읽으면 좋은 자료입니다.